

前回、SSHデコイをPublic Internetに公開して観測してみた。
結果は24時間で3,816接続。
大量の認証試行だけでなく、ログインできたと思ったBotがOSやCPU、GPUを調べ、さらには自分のSSH公開鍵を
authorized_keys に登録しようとするところまで観測できた。そこで最後に、こんな話を書いた。
SSHは、そもそもPublic Internetへ公開しないという選択ができる。
管理者しか使わないのであれば、VPN、WireGuard、Tailscale、踏み台サーバー、送信元IP制限などを利用して、SSHへ到達できる範囲そのものを限定できる。
では、Webサーバーはどうなのだろうか。
一般公開するWebサイトの場合、そうはいかない。
Webは人に見てもらうために公開する。
┌── 人間
│
Internet ──→ HTTPS ─┼── 検索エンジン
│
├── 正常なBot
│
└── 攻撃・探索Bot
人間に開けたHTTP/HTTPSの入口は、当然Botからも見える。
SSHでは入口そのものへの到達を制限できる。しかし一般公開Webでは、入口を開けたまま守らなければならない。
では、特にアクセスを集めるような宣伝をしていないWeb DecoyをPublic Internetに置いたら、その入口には何がやって来るのか。
SSHとは別に Web Decoy を用意して、実際のアクセスを観測してみた。
24時間で1,039リクエスト
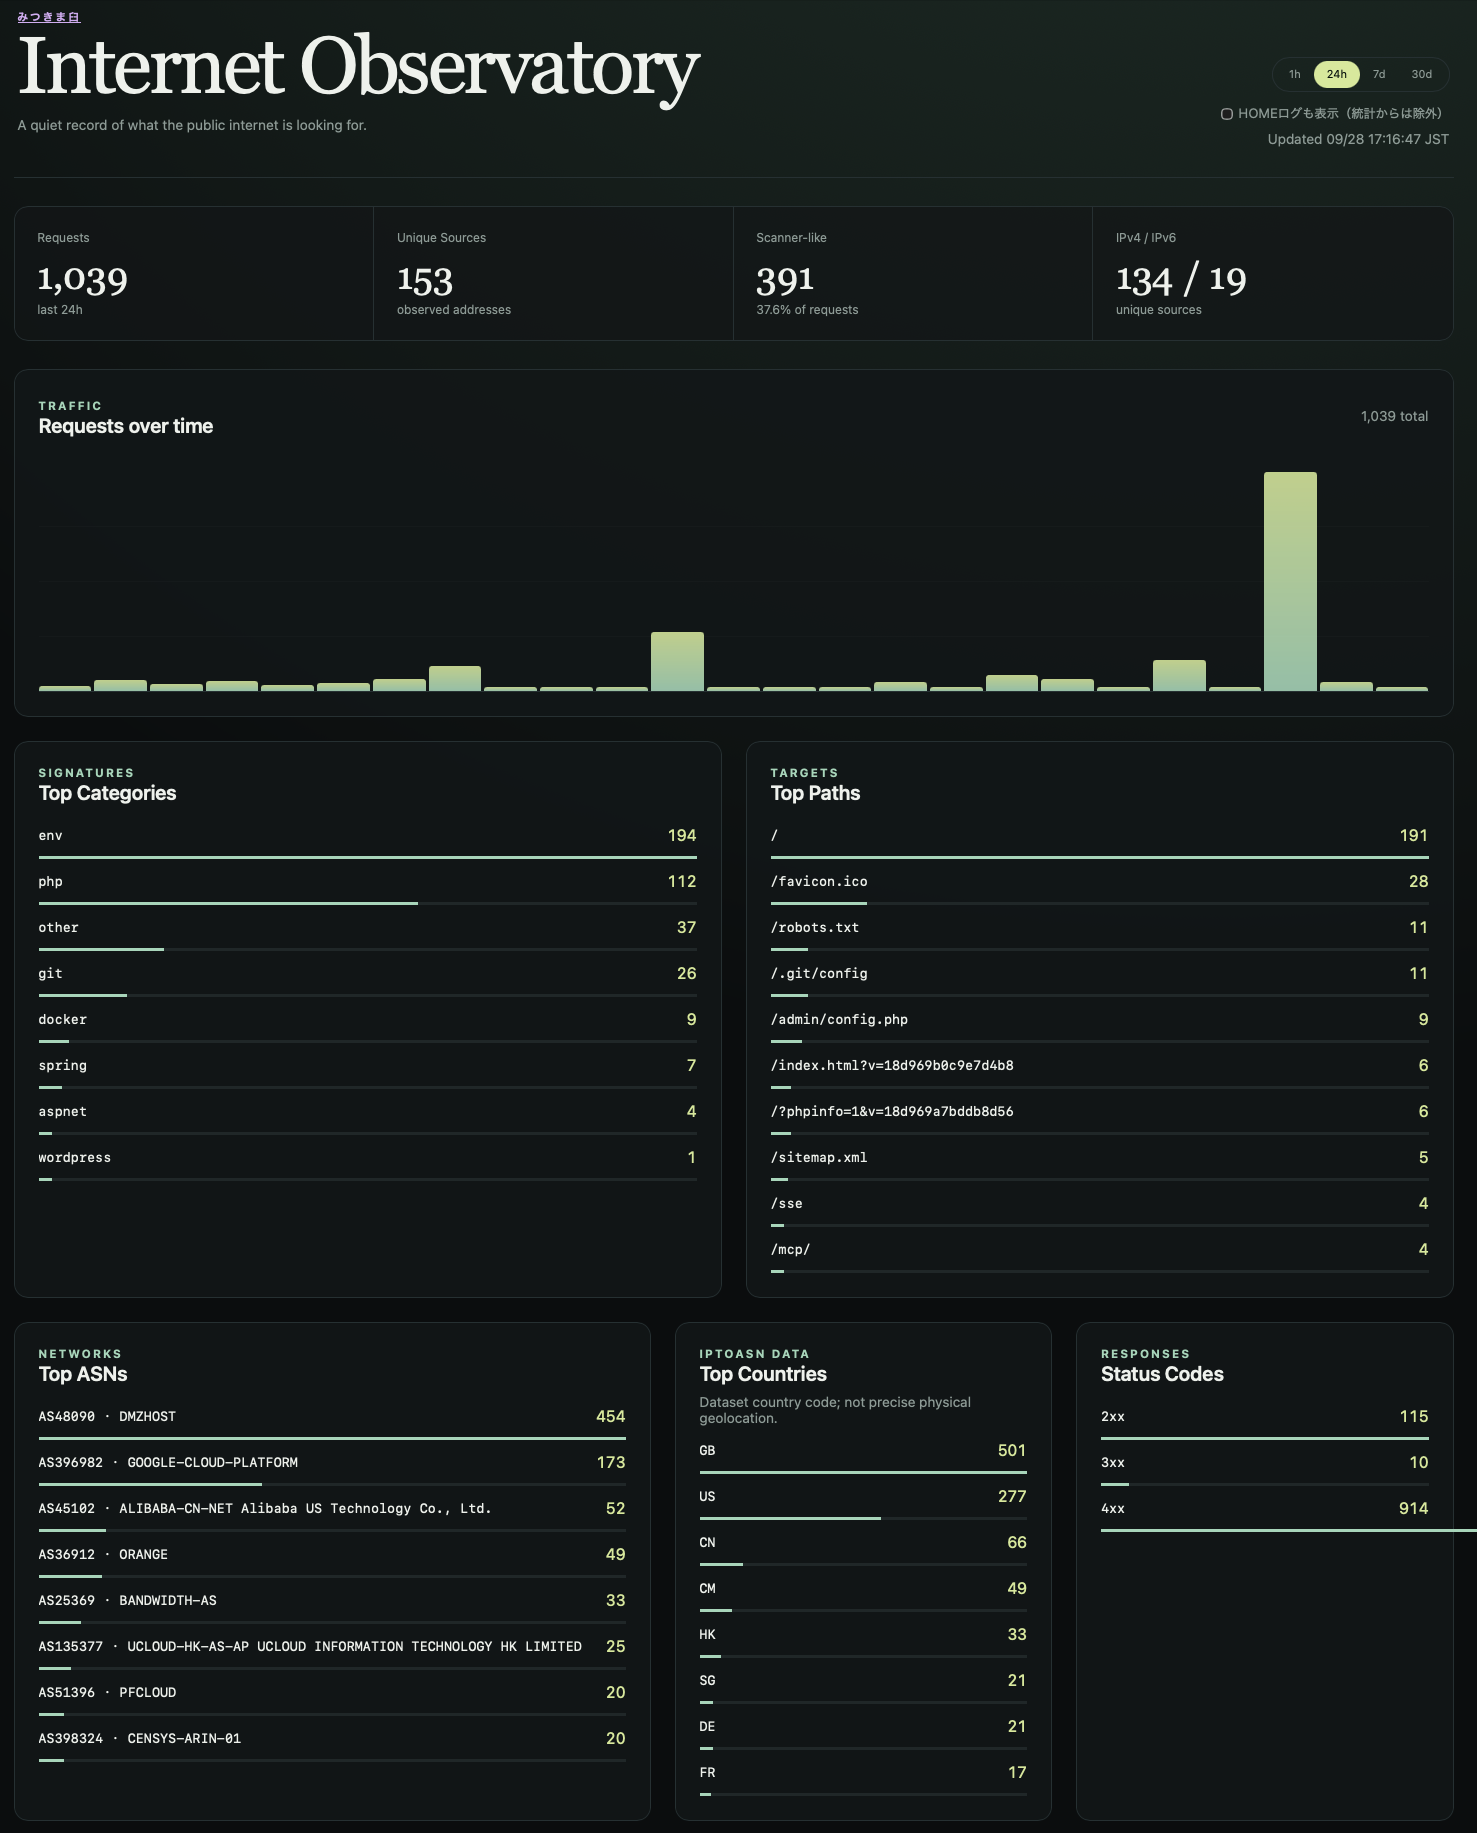
サイトは、みつきま臼のホームページ(何も生産性のない、架空の人物?のネタサイト。)
24時間の観測結果はこうなった。
|
項目
|
24時間
|
|---|---|
|
HTTP/HTTPS Request
|
1,039
|
|
Unique Source
|
153
|
|
Scanner-like
|
391
|
|
Scanner-like率
|
37.6%
|
|
4xx Response
|
914
|
SSHほど件数は多くない。
それでも、何も宣伝していないWeb Decoyに24時間で1,000件以上のリクエストが飛んできた。
さらに興味深いのは、その内容である。
391件、全体の37.6%をScanner-likeなアクセスとして検出した。
そしてレスポンスの大部分、914件は4xxだった。
つまり、普通にWebページを見に来ているアクセスばかりではない。
「そこに何があるのか」を探しているアクセスが大量に混ざっている。
/ だけを見て帰るわけではない
アクセスされたパスを見ると、当然
/ が最も多い。しかし、その後に続くものが面白い。
/
/favicon.ico
/robots.txt
/.git/config
/admin/config.php
/?phpinfo=…
/sitemap.xml
/sse
/mcp/
…
favicon.ico や robots.txt、sitemap.xml だけなら、普通のWebクローラーでもアクセスする。しかし、
/.git/config
/admin/config.php
となると意味が違ってくる。
Webサイトを読みに来ているのではない。
公開してはいけないものが、うっかり公開されていないかを探している。
特に
/.git/config は分かりやすい。WebサーバーのDocument Root配下に
.git ディレクトリを残したまま公開してしまえば、Gitリポジトリに関する情報が外部から取得できる可能性がある。Botは、
このサーバーに.gitがあるかもしれない
と期待してアクセスしてくる。
こちらがGitを使っていると教えたわけではない。
とりあえず聞いてみるのである。
.env を探すBotが大量に来る
今回の観測で特に目立ったカテゴリが
.env だった。ダッシュボード上の分類では、
env 194
php 112
git 26
docker 9
spring 7
aspnet 4
wordpress 1
となっていた。
.env 系だけで194件。.env はWebアプリケーションで環境変数などを管理するためによく使われるファイルである。アプリケーションによっては、
DB_HOST=…
DB_USER=…
DB_PASSWORD=…
API_KEY=…
SECRET_KEY=…
といった情報が格納されていることもある。
もちろん、本来はWebから取得できる場所に置くべきものではない。
しかしBotからすれば、
もし設定を間違えて公開されていたら儲けもの
なのである。
存在することを確認してからアクセスしているわけではない。
片っ端から、
/.env
/.env.local
/.env.production
/.env.backup
…
のような候補を試せばいい。
失敗してもBot側にはほとんどコストがない。
世界中のWebサーバーに対して同じことを自動的に繰り返せる。
PHPを使っていなくてもPHPを探しに来る
PHP関連も112件観測した。
ここでも重要なのは、
こちらがPHPを使っているからPHPを探しに来たとは限らない
ということだ。
Botからすれば、相手の構成を事前に完全に把握する必要はない。
PHPある?
↓
なかった
Gitある?
↓
なかった
.envある?
↓
なかった
Docker関係ある?
↓
なかった
Springは?
↓
なかった
WordPressは?
↓
なかった
これでいい。
人間が一台ずつ調べるなら非常に非効率だが、自動化されたBotなら話は違う。
何万台、何十万台というWebサーバーに同じリクエストを送れば、そのうち設定を間違えたサーバーに当たるかもしれない。
「うちはWordPressじゃないから大丈夫」ではない
今回のアクセスでは、
-
.env -
PHP
-
Git
-
Docker
-
Spring
-
WordPress
など、複数の技術スタックを対象とした探索が観測できた。
これは防御側から見ると重要だと思う。
例えば、
このサーバーはWordPressじゃないから、WordPress向け攻撃は関係ない
というのは、そのサーバーの安全性については正しいかもしれない。
しかし、攻撃リクエスト自体が来ないという意味ではない。
Botはサーバーの構成を知らない。
だから試す。
Web Server発見
↓
.env ある?
↓
PHPは?
↓
.git は?
↓
Dockerは?
↓
Springは?
↓
WordPressは?
↓
何か当たるまで探索
Webサーバー側から見ると、使ってもいない製品やフレームワークを狙った奇妙なリクエストが大量に来ることになる。
しかしBot側から見れば合理的である。
外れてもほとんど損をしないからだ。
200だから「普通の閲覧」とは限らない
今回Web Decoyを観測していて、もう一つ興味深かったことがある。
HTTPステータスコードだけでは、そのアクセスの性質は判断できない。
例えば、
GET /
200
だけを見ると、普通のブラウザがトップページを表示したように見える。
しかし、同じ送信元がその前後に、
/webui/
/.git/config
などを探索していることもある。
つまり、
200 OK= 普通の人間
ではない。
200 は単に、WebサーバーがそのHTTPリクエストを正常に処理した
という意味にすぎない。
そのリクエストを送った相手が、人間なのか、検索エンジンなのか、セキュリティスキャナなのか、脆弱性を探しているBotなのかは別の話である。
そこで今回のWeb Decoyでは、
HTTP処理結果
+
アクセス行動
を分けて見るようにした。
これは思った以上に重要だった。
400にもいろいろある
逆に
400 Bad Request も、単純に「変なアクセス」とひとまとめにはできなかった。実際に観測したアクセスの中に、
GET /
400
というものがあった。
User-Agentだけを見ると、古いiPhoneのSafariのように見える。
最初は、
Safariを装った雑なBotが壊れたHTTPリクエストを送ってきたのだろうか
と思った。
しかしログを詳しく調べると、決め手になったのがレスポンスサイズ264バイトだった。
実機で使っているnginx 1.28.3では、HTTPS待受ポートにTLSではなく平文HTTPを送った場合に返す専用の400レスポンスがあり、その本文サイズと一致した。
通常の構文不正による400とはサイズが異なっていた。
つまり、このアクセスは高い確度で、
Client
│
│ TCP接続
▼
HTTPS port
│
│ 本来なら TLS ClientHello
│
└──→ 平文 HTTP を送信
↓
nginx が検出
↓
400 Bad Request
だったと考えられる。
ただし、当時のHostヘッダーや全HTTPヘッダー、接続先ポートそのものを保存していなかったため、通信記録から直接確定できたわけではない。
したがって、これは高確度の推定として扱っている。
この出来事をきっかけに、Web Decoy側でも
200 と 400 を単純に同じ「アクセス」として扱わず、2xx 正常HTTP応答
3xx Redirect
400 不正HTTPリクエスト
400/264 HTTPSポートへの平文HTTPの可能性
401/403 拒否
404 存在しないパス
5xx Server Error
というように、HTTP処理結果も分けて観測することにした。
User-Agentも信用しすぎない
先ほどの400アクセスでは、User-AgentはiPhone Safariを名乗っていた。
しかし、User-Agentはクライアントが自由に送る文字列である。
Botが、
Mozilla/5.0 (iPhone; …)
と送れば、ログ上はiPhoneに見える。
Chromeを名乗ることも、Googlebotを名乗ることもできる。
したがって、
User-AgentがSafariだからiPhoneユーザー
とは限らない。
Web Decoyを見ていると、
送信元IP
User-Agent
アクセスパス
HTTP status
時間的な連続性
同じIPからの別リクエスト
などを組み合わせないと、アクセスの性質は分からないことがよくある。
これは普通のWebアクセスログを眺めているだけでは、なかなか意識しないところだった。
Webへのアクセスも一日中均等ではない
SSH編でも、アクセスは24時間均等に来るわけではなかった。
Webも同じだった。
時間別グラフを見ると、普段は比較的少ないアクセスが続いているのに、特定の時間帯に突然大きな山ができる。
つまり、
1日 1,039 requests
だからといって、
1039 / 86400
のペースで一定にリクエストが来ているわけではない。
実際には、
静か
↓
静か
↓
突然大量のスキャン
↓
静か
↓
別のBot群
という動きになる。
SSHでも同じようなwaveが観測された。
インターネット上の自動探索は、一定速度で降り続ける雨というより、時々まとまって通過していく雨雲のような動きをする。
4xxが多いのは、ある意味正常だった
今回の24時間では、1,039リクエストのうち914件が4xxだった。
最初に数字だけを見ると、
ずいぶんエラーが多い
ように見える。
しかしアクセス内容を見ると、むしろ当然だった。
Botが、
/.env
/.git/config
/admin/config.php
…
と、存在するかどうかも分からないものを大量に問い合わせている。
存在しなければ
404 Not Found になる。不正なHTTPなら
400 Bad Request になる。アクセス制御に引っかかれば
403 Forbidden になる。つまりWeb Decoyの場合、4xxの多さは単純な「サーバーの異常」ではない。
Botが何かを探して外し続けた結果でもある。
一般的なWebサービスの監視では4xx率の上昇を問題として扱うこともあるが、Public Internetから直接受けるアクセスを分析する場合は、誰が何を要求した結果の4xxなのかを見る必要がある。
Webは閉じることができない
SSH編では、
そもそもSSHをPublic Internetへ公開する必要があるのか
という話を書いた。
管理用途だけなら、SSHへの到達範囲そのものを狭くできる。
Webは事情が違う。
一般公開Webサイトなら、
Human ────────┐
Search Engine ─┤
Normal Bot ────┼──→ HTTPS → Web Server
Scanner ───────┤
Attack Bot ─────┘
となる。
サーバー側から見れば、最初は全員同じHTTP/HTTPSの入口からやって来る。
だから、
怪しい相手を一切入口に来させない
という設計だけでは解決できない。
来ることを前提に、来ても壊れないようにする必要がある。
「秘密のURLだから大丈夫」は通用しにくい
今回の観測でも分かるように、Botはリンクを辿っているだけではない。
存在しそうなURLを自分から生成して試している。
つまり、
Webサイトからリンクしていないから見つからない
とは限らない。
/.env
/.git/config
/admin/
/backup/
/phpinfo.php
のような典型的な名前なら、公開した瞬間から探索対象になり得る。
管理画面などを単に「分かりにくいURL」にしただけでは、本質的なアクセス制御にはならない。
認証、ネットワーク制限、適切なWebサーバー設定など、別の境界が必要になる。
Webを公開するなら、Botが来ることを正常系として考える
今回Web Decoyを動かして一番印象に残ったのは、
攻撃・探索Botからアクセスされること自体は、Public Web Serverにとって異常事態ではない
ということだった。
24時間で1,039リクエスト。
153の送信元。
Scanner-likeなアクセス391件。
.env を探すBot。Gitの設定ファイルを探すBot。
PHPを探すBot。
DockerやSpringを探すBot。
HTTPSポートへ平文HTTPを投げるクライアント。
普通のブラウザを装うUser-Agent。
こうしたアクセスが、何か特別な事件が起きたから来たわけではない。
ただWebサーバーがPublic Internetに存在しているから来た。
だからWebサーバーを公開するときは、
-
.envや秘密情報をDocument Rootに置かない -
.gitなど開発用ファイルを公開しない -
不要な管理画面やデバッグ機能を公開しない
-
使用しているWebサーバー、CMS、フレームワークを更新する
-
不要なサービスやエンドポイントを無効化する
-
認証が必要な場所には正しく認証を設定する
-
アクセスログを保存・監視する
-
必要に応じてWAF、CDN、Rate Limitなども利用する
といったことが必要になる。
これは「攻撃を受けたときの特別対応」ではない。
インターネットにWebを公開するための通常運用の一部なのだと思う。
SSHとWeb、両方をデコイにしてみて
SSHとWebを続けて観測してみると、両者の違いが面白い。
SSH
│
├── 公開しないという選択ができる
├── 認証突破を狙われる
└── 入られると内部で次の処理が始まる
Web
│
├── 一般公開サイトなら入口を閉じられない
├── 構成や弱点を外側から探索される
└── Botも人間も同じHTTP/HTTPSから来る
しかし共通していることもある。
Public Internetにサービスを置いた瞬間から、自動化された探索の対象になる。
こちらが有名なサイトだからではない。
誰かに恨まれているからでもない。
検索エンジンに登録したからでもない。
そこにIPアドレスとサービスが存在し、外から到達できるからである。
SSH編では、
そもそも、その入口を世界中に公開する必要があるのか
という問いになった。
Web編では逆に、
入口を開けておかなければならないなら、Botが来ることを前提にどう守るのか
という問いになる。
デコイを置いてみて見えたのは、「インターネットは危険」という漠然とした話ではなかった。
公開したサービスは常に誰かに探されている。しかも、その「誰か」の多くは、人間ではなく自動化されたBotである。
Webサーバーを公開するということは、人間にページを届ける入口を作ると同時に、そうしたBotに対しても入口を置くということなのだ。